В мифе о потопе вода добралась до виноградников, а дельфины уже резвятся среди леса. Когда открываешь полную RSS-ленту в очередной раз, иногда хочется выдать вчерашним новостям такие же плавники: пусть наконец уплывут. Новое объявление там есть, только до него снова надо добраться через знакомые заголовки.
Допустим, вы следите за музейными прогулками по городу. Из ленты приходят объявления, которые хочется просматривать по мере появления. Вчерашняя прогулка у реки уже замечена, позавчерашняя тоже. Сегодня лента отдаёт их снова вместе с новой записью. Старая афиша зашла ещё раз, как человек, который забыл, что уже поздоровался, и теперь намерен начать знакомство заново. У каждой афиши есть свой номер. Если записать уже встреченные номера, в следующий раз можно оставить только незнакомые. Добавим эту небольшую память в схему обработки.
Результат здесь — выход с ранее не обработанными идентификаторами. На него впоследствии можно опереться в своей задаче. Пока достаточно увидеть правильные записи в n8n: без рассылки, публикаций и настройки нового канала.
Как устроить RSS в n8n с памятью о прочитанном
RSS — лента записей, которую сайт отдаёт по отдельному адресу. В каждой записи обычно есть заголовок, ссылка и другие поля. Для нашего способа нужно поле guid: устойчивый идентификатор записи. Представьте номер на карточке афиши. Заголовок можно поправить, а номер у той же записи должен остаться прежним.
Первый узел читает ленту. Второй сравнивает номера с теми, что уже встречал в прошлых запусках, и оставляет незнакомые. Так один и тот же источник можно читать повторно, не пропуская на выход всю его историю каждый раз.
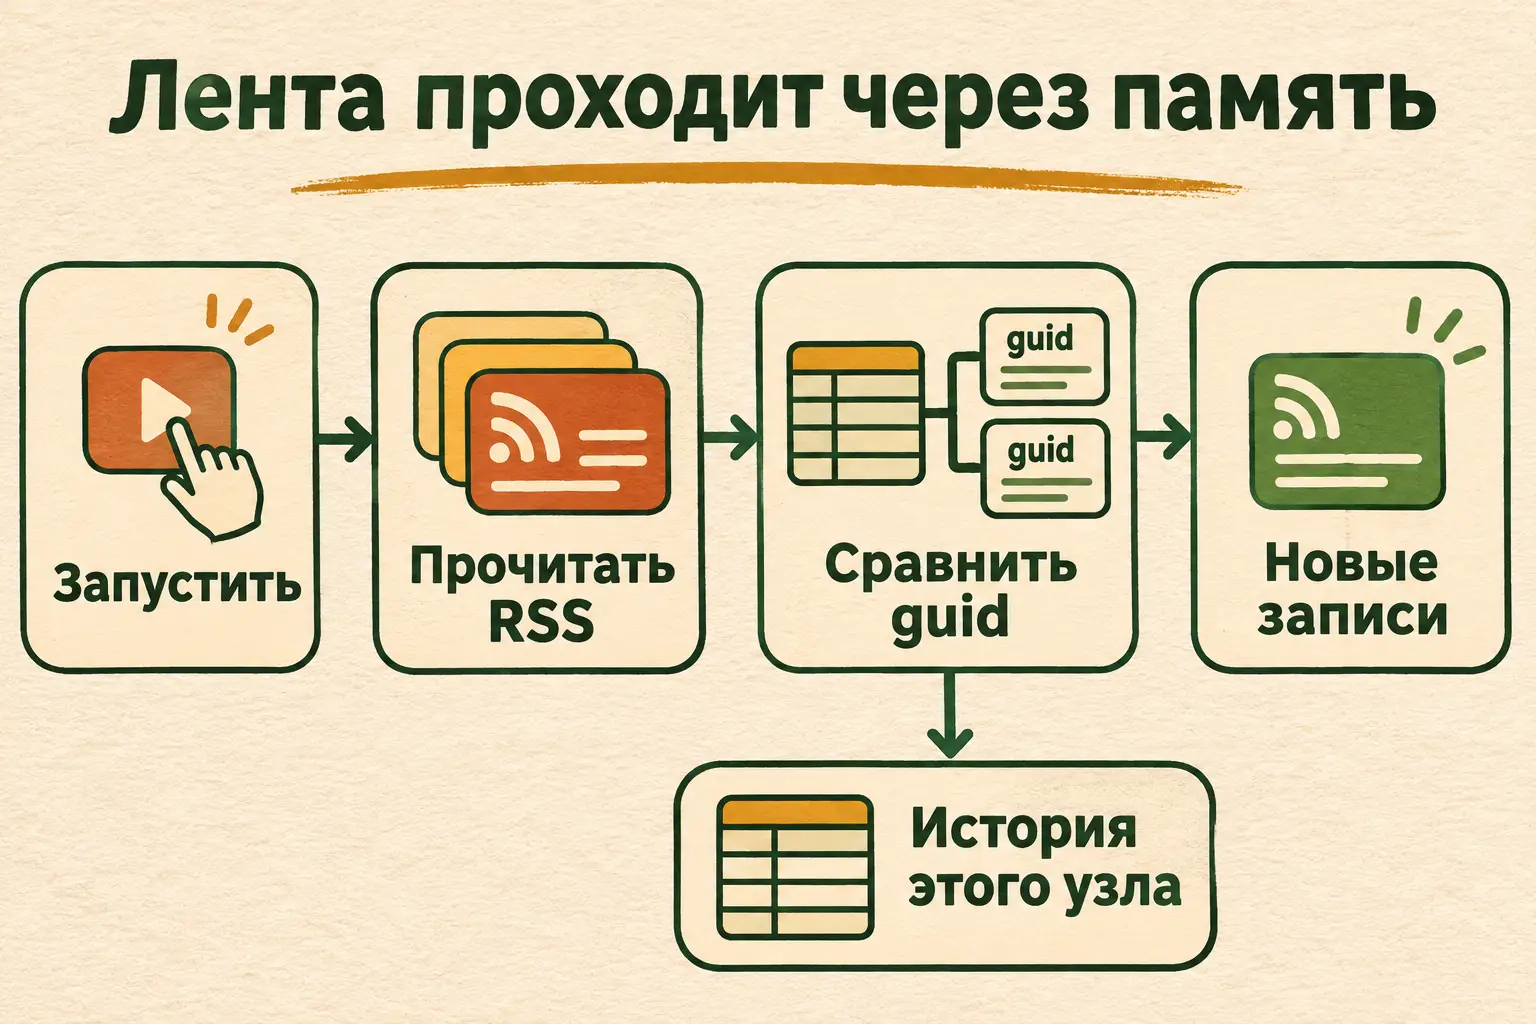
Схема workflow: на рабочем поле этим действиям соответствуют Manual Trigger, RSS Read и Remove Duplicates.
Нужна уже доступная вам среда n8n версии 1.64 или новее с обновлённым Remove Duplicates. Для полного упражнения возьмите разрешённую публичную ленту с устойчивыми guid и заранее договорённой контрольной новой записью. Удобнее своя учебная лента: вы или её владелец можете добавить одну запись, не меняя номера прежних. Установка n8n и создание сайта с лентой — отдельные задачи; этот маршрут начинается с готовой среды и адреса.
Перед первым запуском цель маленькая: увидеть несколько записей ленты и найти у них guid. Если сам интерфейс пока непривычен, откройте DeepSeek и попросите провести вас по этому пути:
У меня уже есть доступ к n8n и разрешённый URL RSS-ленты. Хочу оставить только новые guid по сравнению с предыдущими запусками. Сначала уточни версию n8n. Затем помоги собрать Manual Trigger → RSS Read → Remove Duplicates. Давай одно действие: что открыть, куда вставить значение и что я должен увидеть. После шага жди моего ответа. В Remove Duplicates нужна история этого узла, Scope Node, без очистки чужой истории. Если команда отличается, сверь её с официальной справкой, когда доступен поиск.
Помощнику достаточно описать экран или привести обезличенный фрагмент ошибки. Пароли, ключи доступа и закрытые адреса с токенами в запрос не включайте. Если поиска у чата нет, дайте ему нужный фрагмент справки из ссылок ниже.
Сначала прочитайте свою ленту
В отдельном учебном workflow добавьте Manual Trigger — начало, которое позволяет запускать схему вручную. Соедините его с узлом RSS Read. В поле URL вставьте полный адрес своей RSS-ленты, затем выполните шаг чтения. Параметр URL описан в официальной справке RSS Read.
Откройте выход RSS Read. Убедитесь, что перед вами отдельные записи, а не текст ошибки или страница сайта. Найдите guid и посмотрите значения хотя бы у двух записей. Это должны быть разные непустые идентификаторы. Адрес главной страницы музея сам по себе может не быть адресом его ленты. Ориентир здесь — полученные записи и поле guid; если вместо них открылась ошибка чтения, до узла сравнения пока не переходите.
В примере будем обозначать две исходные записи как walk-01 и walk-02, а будущую новую — walk-03. У вашей ленты будут свои значения, иногда длинные ссылки или строки. Набирать наши обозначения вместо настоящих идентификаторов не нужно.
Если guid нет, выбранный вход этому методу пока не соответствует. Возьмите ленту с таким полем или отдельно разберите с её владельцем устойчивый идентификатор. Подмена на название незаметно меняет правило сравнения: два разных объявления могут называться одинаково.
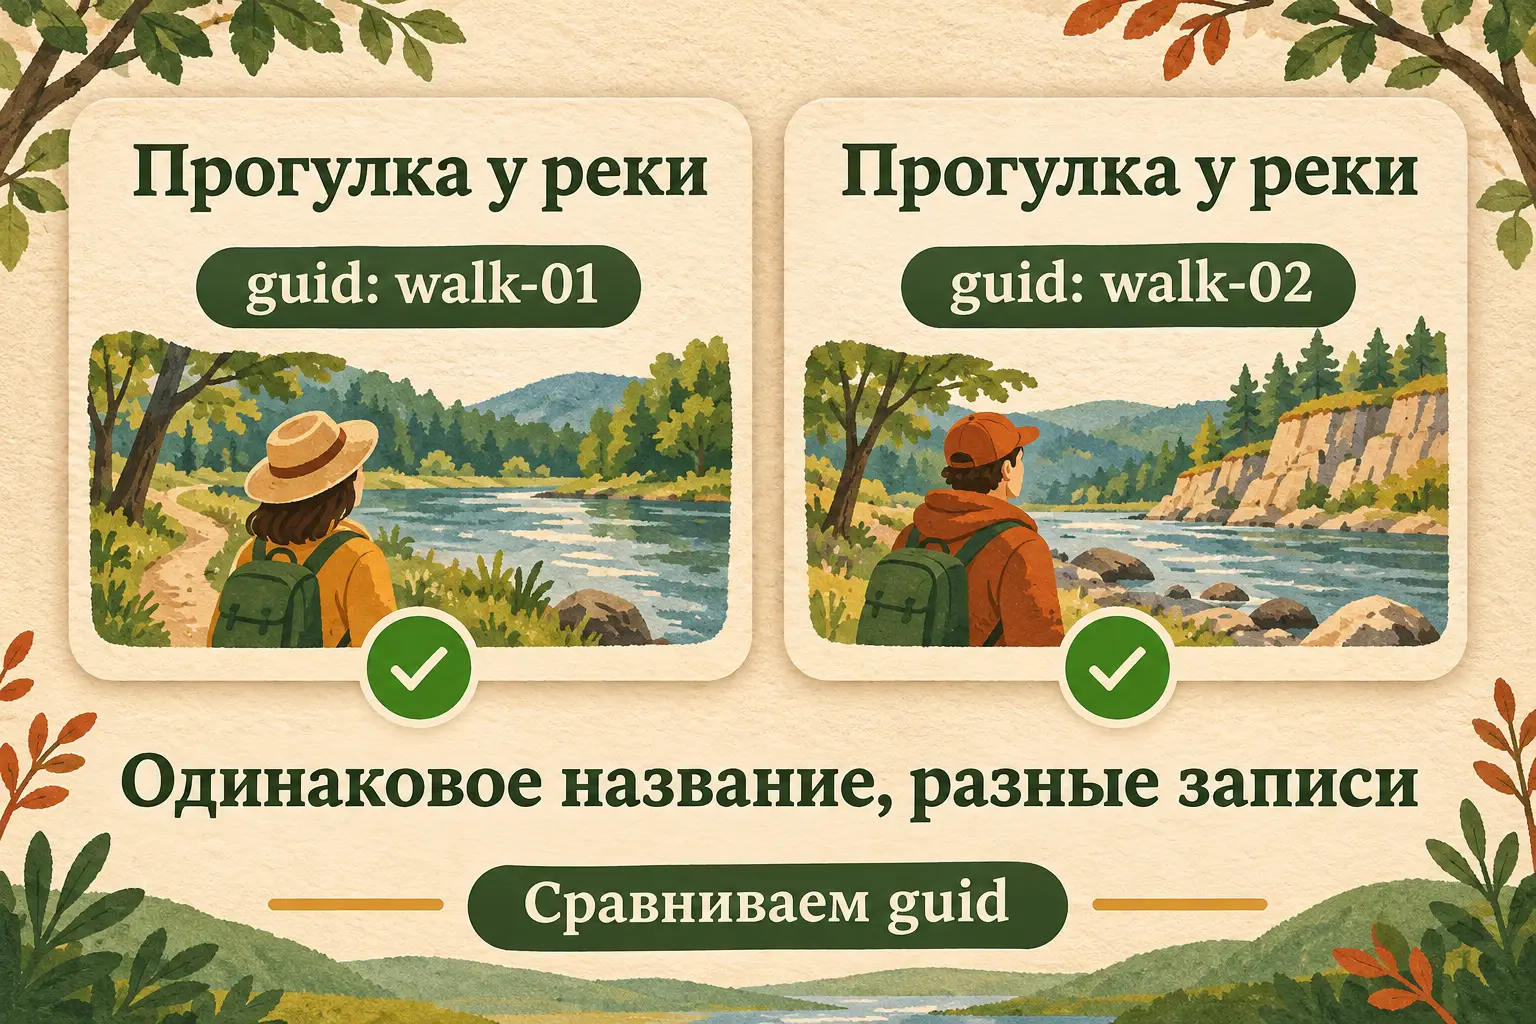
Для примера это две разные записи. Номер карточки важнее совпадения названий; сравниваем guid.
Затем добавьте историю одного узла
После RSS Read поставьте Remove Duplicates и соедините их. Внутри него выберите такие настройки:
- Operation → Remove Items Processed in Previous Executions. Сравнивать с записями, обработанными в прошлых запусках.
- Keep Items Where → Value Is New. Оставлять запись, если её значение ещё не встречалось в истории.
- Value to Dedupe On → значение guid текущей записи. Перетащите поле guid из входных данных в это поле как выражение. Оно должно читать номер каждой записи, а не содержать одинаковое для всех слово «guid».
- В Options оставьте или установите Scope → Node. История будет относиться к этому экземпляру узла; другие узлы не должны участвовать в нашем опыте.
Для выражения используется {{ $json.guid }}. Вставлять его нужно в поле Value to Dedupe On в режиме выражения, а не в URL ленты и не в окно чата. На просмотре входных записей оно должно возвращать их настоящий guid — например, один номер для первой карточки, другой для второй.
Выбирайте именно сравнение с прошлыми запусками. Операция Remove Items Repeated Within Current Input убирает повторы только внутри текущего входа. Это другое действие: оно не отвечает на вопрос, видели ли вы запись вчера. Различие и параметры описаны в справке Remove Duplicates.
Дальше смотрите выход Kept — записи, которые узел оставил. Для чтения исходной ленты возвращайтесь к RSS Read. При повторном чтении RSS в n8n источник может снова вернуть старые записи, а фильтр должен оставить только новые для своей истории. Сравнение двух выходов показывает, где именно они отсеялись.
Три прохода вместо одного удачного кадра
До контрольных запусков откройте меню workflow, затем Settings и проверьте Save manual executions — сохранение ручных запусков. Оно нужно, чтобы потом открыть свои три выполнения и сопоставить выходы. Настройка описана в справке workflow settings.
Запускайте весь workflow кнопкой Execute workflow. Между проходами используйте тот же экземпляр Remove Duplicates с той же историей. Не создавайте второй узел вместо первого и не очищайте историю ради пустого повтора.
Для примера у нового учебного узла история сначала пуста. Контрольная лента содержит два разных guid, без повторов внутри одного ответа. Ожидаемая последовательность такая:
| Проход | Что сейчас отдаёт лента | Что должно остаться в Kept |
|---|---|---|
| Первый | walk-01 и walk-02 | walk-01 и walk-02 |
| Второй, лента не менялась | walk-01 и walk-02 | Пусто |
| После добавления новой записи | walk-01, walk-02 и walk-03 | Только walk-03 |
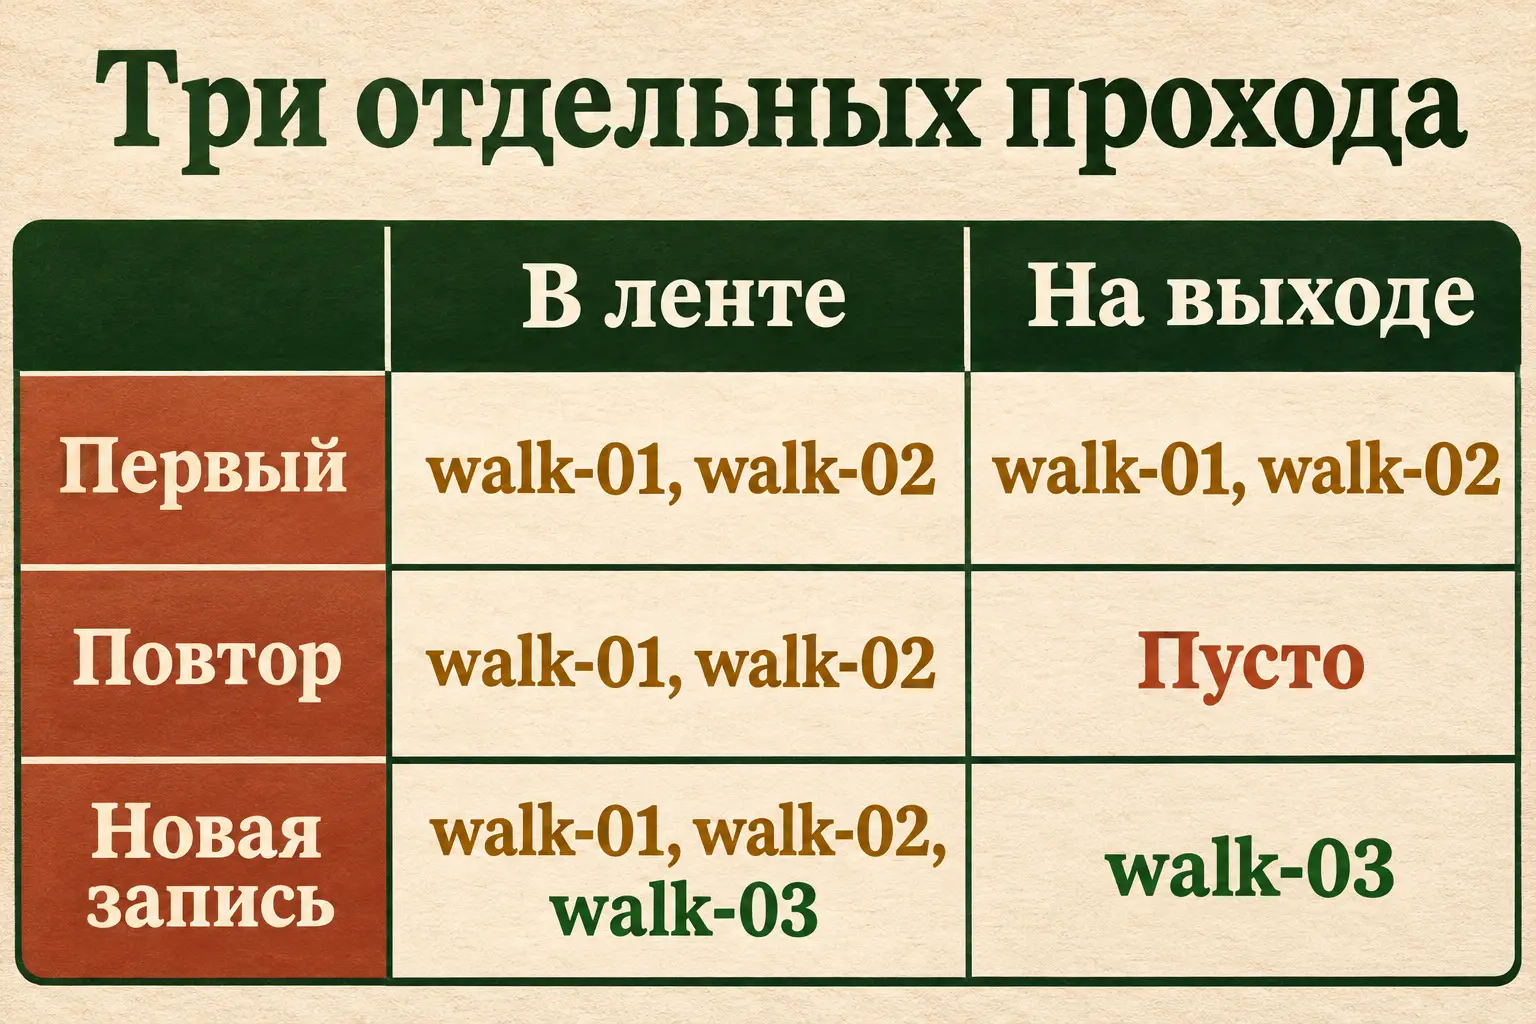
Схема ожидаемых выходов при пустой исходной истории: сначала два guid, затем ни одного, затем только новый.
В первом проходе узел ещё не знает ни одного номера и пропускает исходные записи. Если цель — следить только за будущими объявлениями, считайте этот проход знакомством с существующей лентой. При втором запуске те же номера уже знакомы. Пустой Kept здесь показывает, что память участвует в сравнении. Тишина наконец стала результатом: вчерашним экскурсиям не выдали ещё по одному входному билету на ваш вечер.
Затем добавьте в свою учебную ленту новую запись с новым guid либо дождитесь заранее известной контрольной публикации её владельца. Старые записи и их номера оставьте прежними. Снова выполните весь workflow: в Kept должен появиться новый номер, а старых там быть не должно. Если повторить чтение после этого без изменений, этот номер тоже уже не будет новым.
Не подменяйте третий проход ручным изменением выходной таблицы. Проверяется связка чтения реальной ленты и сравнения с сохранённой историей. Для чужой ленты, которую нельзя менять, дождитесь фактической новой записи: придумывать её появление для галочки незачем.
Оставьте себе журнал и экспорт
В журнале Executions для каждого прохода посмотрите данные RSS Read и Kept у Remove Duplicates. Запишите рядом номер выполнения и выходные guid. Во втором проходе так и отметьте «Kept пуст». В третьем выпишите конкретный новый guid, чтобы потом не гадать, какая из двух одинаково названных прогулок пришла. Одно лишь число записей недостаточно для третьего: убедитесь, что это именно новая карточка, а не старая, случайно вернувшаяся на выход.
Настройка сохранения ручных запусков и история сравнения — разные вещи. Журнал помогает вам изучать выполнения, а Remove Duplicates использует свои данные для сопоставления значений. Наличие красивого списка запусков не заменяет проверку пустого второго прохода.
Когда все три результата совпали, сохраните workflow и скачайте его описание: в меню workflow выберите Download. n8n выгружает схему в JSON; путь есть в официальной справке экспорта. Назовите файл понятно, например museum-rss-new-items.json. Экспорт сохраняет описание настройки; его не следует считать отдельным архивом всей накопленной истории узла.
Вопросы и ответы о новых записях
Почему первый запуск показал старые объявления? Для пустой истории это первые встреченные значения. Слово «новое» здесь означает «не встречалось этому узлу в пределах его истории». Проверка второго и третьего проходов показывает, как правило работает дальше.
Почему старые записи снова проходят? Сначала посмотрите, не поменялся ли сам guid, остался ли тот же узел, выбран ли нужный режим и Scope Node. Затем проверьте выражение: оно должно брать значение поля у каждой записи. Смена заголовка при прежнем guid не делает запись новой для этого правила. Исправление текста в уже прочитанной афише тоже не пройдёт как новый номер: отслеживание правок потребует другого решения.
Что будет через много запусков? Объём истории ограничен параметром History Size. У него конечная вместимость; после вытеснения старого номера он снова может считаться незнакомым. Для своей ленты подбирайте объём под количество сохраняемых идентификаторов. Этот простой способ не заменяет отдельный долговременный реестр.
Одинаковый guid дважды пришёл в одном ответе. Он пройдёт один раз? Режим сравнивает текущие записи с прошлыми выполнениями, а не друг с другом. Для такого входа n8n отдельно описывает два последовательных узла: сначала убрать повторы внутри текущего входа, затем сравнить с историей. Наш контрольный пример начинается с разных guid; расширение разобрано в примерах Remove Duplicates.
Это уже готовые уведомления? Пока вы получили проверенный выход новых записей. Доставка, повтор после сбоя отправки и одновременные запуски — следующие задачи со своей проверкой. Здесь результат виден непосредственно в Kept, и его достаточно, чтобы закончить первый опыт.
Если хочется продолжить автоматизацию со своей понятной задачей, посмотрите практику с ботами. При разборе следующего узла пригодится способ объяснить ИИ желаемый результат.
Ваша лента всё ещё помнит прежние прогулки, и это хорошо: архив остаётся архивом. На выходе же лежит одна новая карточка. Можно прочитать её и выбрать, куда пойти в выходные, а вчерашним дельфинам не придётся снова устраивать показательное плавание по вашему экрану.