У царя Эака опустел остров. Он увидел муравейник и попросил Зевса дать ему столько же трудолюбивых граждан. В мифе просьба сработала: муравьи превратились в людей. С таблицей хочется примерно того же. Нашёл файл на полтораста строк, нажал кнопку — получил маленькое государство, которое умеет узнавать цветы.
Но в маленькое государство уже идут близнецы с одинаковыми документами. Одна строка повторяет соседнюю, у другой в анкете ошибочный рост — и об этом давно предупреждает сам источник. Прежде чем учреждать Министерство безошибочной ботаники, посмотрим, кто вообще пришёл. Для этого возьмём Iris: небольшой настоящий набор измерений ирисов из репозитория UCI.
Здесь можно пройти весь путь глазами. Не нужно сначала собирать тысячи фотографий или платить за сервис. В конце будут исходник, короткая записка о его происхождении и три CSV с разными ролями. Обучение самой модели — следующее дело.
Где взять данные для обучения нейросети и что сохранить рядом
Откройте карточку Iris в UCI. Убедитесь, что речь о наборе с четырьмя измерениями цветка и тремя классами. Из карточки перейдите к исходному CSV, сохраните его как iris.csv в отдельную папку. Исходник оставьте нетронутым: рабочие файлы появятся рядом.
CSV — обычный текст с таблицей внутри. В первой строке стоят названия столбцов, дальше идут значения, разделённые запятыми. Его можно открыть текстовым редактором или импортировать в табличную программу. Если всё оказалось в одной колонке, при импорте нужен разделитель «запятая». Десятичный знак исходника — точка: число 5.1 означает пять целых и одну десятую.
Рядом создайте текстовую заметку источник.txt. Достаточно записать название Iris, ссылку на карточку, автора R. A. Fisher, год 1936, лицензию CC BY 4.0 со ссылкой и дату скачивания. Эта лицензия требует указать авторство; при распространении изменённого материала нужно обозначить и изменения. Ссылка на источник и две строки о подготовке помогут сделать это без археологических раскопок через месяц.
Первый результат уже перед вами: сохранённый внешний файл с понятным происхождением. Если помощник вместо объяснения предлагает придумать похожие цветы, верните его к этому исходнику. Сочинять новые примеры здесь незачем.
Один цветок помещается в одну строку
Откройте начало файла. Первая запись выглядит так:
5.1,3.5,1.4,0.2,Iris-setosaЭто один измеренный цветок. Четыре числа слева описывают его размеры в сантиметрах: длину и ширину чашелистика, затем длину и ширину лепестка. Последнее поле сообщает класс — Iris-setosa. В задаче классификации модель должна научиться связывать размеры с этим ответом.
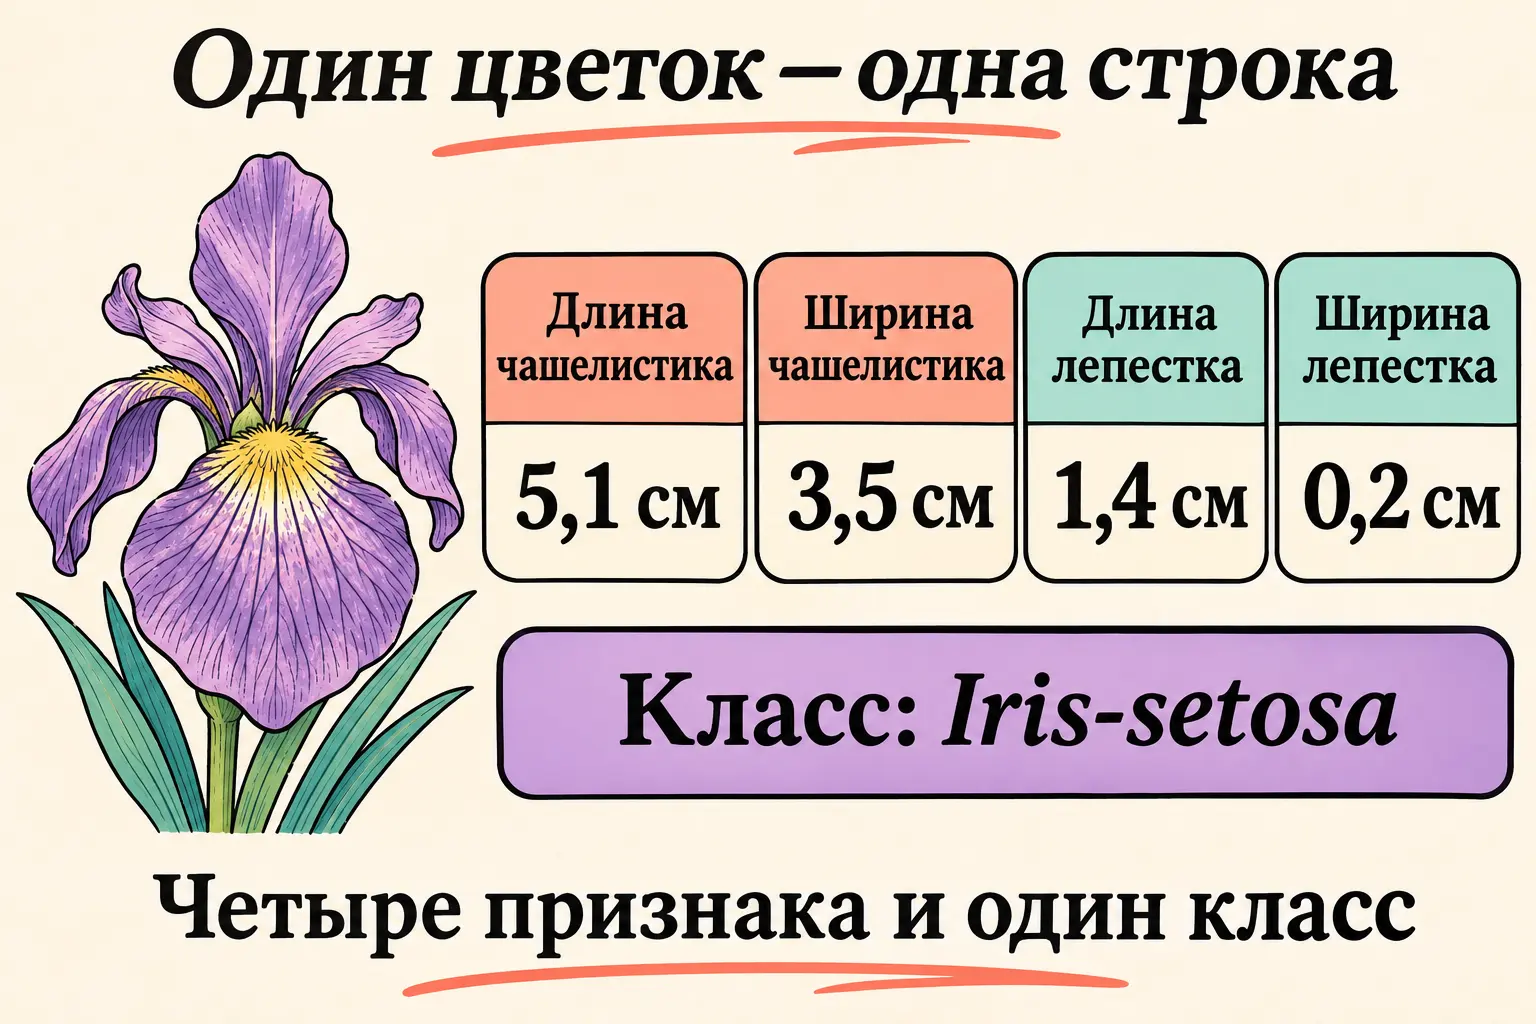
Один цветок — одна строка CSV: четыре признака в сантиметрах и отдельный класс.
| Что видно в файле | Что это значит для задачи |
|---|---|
| Одна строка после заголовка | Один наблюдаемый цветок |
| Четыре числовых столбца | Признаки, по которым будем различать цветы |
Столбец class |
Известный правильный ответ для примера |
| Три названия классов | Три возможных ответа будущего классификатора |
В наборе 150 наблюдений, по 50 для каждого класса. Пропусков карточка UCI не указывает. Это удобный размер, чтобы понять устройство материала: можно посмотреть строки, сравнить несколько цветов и не утонуть в огромном архиве.
На подписи в верхней строке полезно смотреть как на вопросы о цветке. Признак — то, что известно о новом цветке до ответа. Целевой класс — то, что собираемся определить. Если подать название вида среди входных признаков, цветок явится на экзамен с табличкой «Я сетоза». На вопрос он ответит блестяще; измерять лепестки ради этого не стоило.
Попросите ИИ объяснить файл, прежде чем его менять
Откройте DeepSeek и вставьте заголовок, первые пять строк и нужный фрагмент описания из карточки UCI. Для первого объяснения этого хватит. Можно написать так:
Разбираюсь с открытым набором Iris из UCI. Хочу понять таблицу и подготовить её к будущему обучению классификатора. Вот названия полей, пять строк и описание источника. Объясни на одной строке, что является объектом, признаками, единицами измерения и правильным ответом. Не придумывай недостающие строки. Затем спроси, в какой программе и на каком устройстве я работаю. Веди по одному действию: что открыть, что сделать и что должно получиться. Жди моего ответа.
Так помощник получает материал и понятную задачу. Он может объяснить, почему при импорте число стало текстом, помочь найти столбец с классом или разобрать сообщение программы. Чат не видит ваш файл целиком, если вы передали только начало. Число пропусков во всех строках он по этому отрывку тоже не узнает.
Для проверки целого файла потребуется сам CSV в программе, которая умеет его обработать. Если помощник может работать с вложением, приложите открытый исходник; если отвечает только текстом, пусть поможет пройти действия в вашей программе. Способ обращения удобно уточнить по статье о запросе под свою задачу.
Два одинаковых жителя и одна спорная группа
Теперь посмотрим на подготовленный разбор всего исходника. Четыре числовых поля прочитаны как числа, пустых полей не обнаружено. При сравнении всех пяти значений нашлись повторяющиеся строки. После сведения точных совпадений из 150 наблюдений осталось 147 уникальных записей.
Повтор ещё не делает строку ошибочной: разные растения могут дать одинаковые измерения. По этим пяти столбцам мы не установим, один цветок измерили дважды или встретили двух похожих. Для нашей небольшой демонстрации выбираем простое правило: каждая полная комбинация значений участвует один раз. Выбор записываем, исходник сохраняем.
Есть и более интересная деталь. В карточке UCI отдельно названы расхождения в исходных наблюдениях 35 и 38. Номер здесь считают по цветкам, без строки заголовка. Для 35-го источник предлагает ширину лепестка 0.2 вместо 0.1. Для 38-го — ширину чашелистика 3.6 и длину лепестка 1.4 вместо 3.1 и 1.5.
В скачанном файле оба наблюдения совпадают ещё и с 10-м: у всех полная строка 4.9,3.1,1.5,0.1,Iris-setosa. Поэтому мы отложили всю эту группу одинаковых значений. После объединения повторов это одна уникальная запись. На разбиение осталось 146.
Исправить две ячейки незаметно было бы легко. Тогда через неделю уже не разобраться, почему ваш CSV отличается от файла UCI. Здесь оригинальные значения остаются в исходнике, предложенные поправки — в записке, спорная группа — за пределами трёх рабочих частей. Это выбранный способ подготовки именно этого примера.
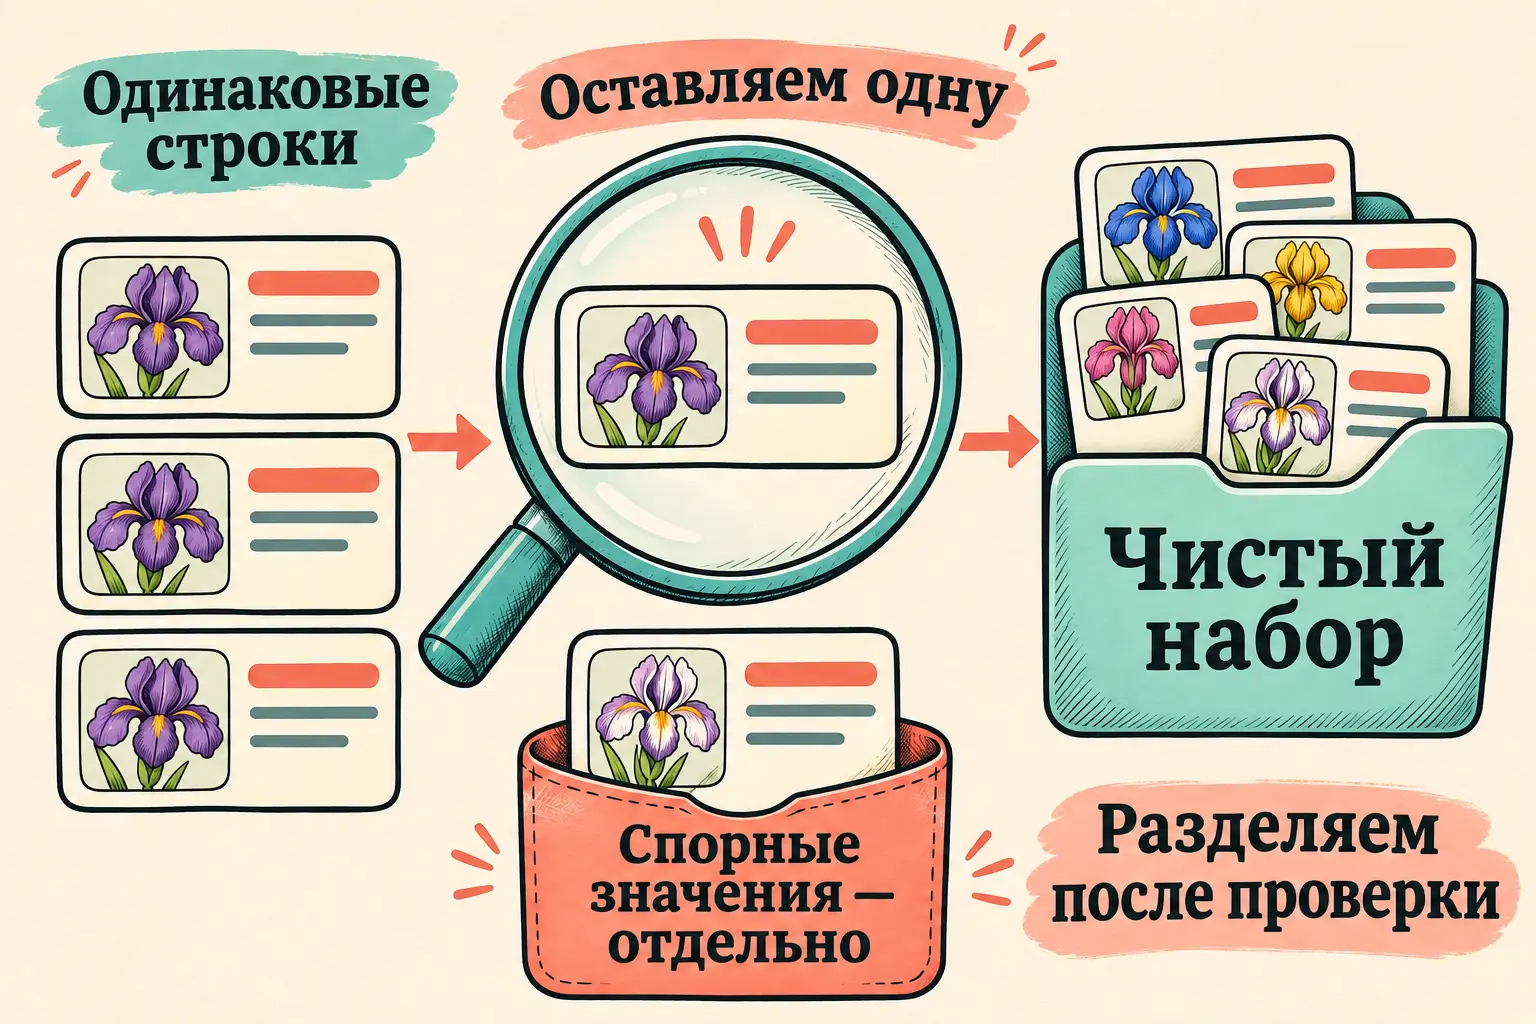
Точные совпадения сравнивают по всей строке, включая класс. Спорную группу в этом примере не разносят по рабочим файлам.
Зачем одному набору три отдельных файла
Представьте, что вы учите ребёнка различать растения. На одних карточках объясняете признаки. На других смотрите, какое объяснение помогло лучше. И держите ещё одну пачку, которую не показываете до итоговой проверки. А теперь положим один снимок во все три пачки. Ребёнок узнает загнутый угол и пятнышко от чая. Мы похвалим знание ботаники, хотя он прекрасно изучил нашу канцелярию.
У данных те же три роли. На обучающей части модель подбирает внутренние параметры. На валидационной сравнивают решения и выбирают настройки. Тестовую оставляют для итоговой оценки выбранного варианта. Такой порядок описан в уроке Google о разделении набора.
В нашем примере уникальные записи внутри каждого класса упорядочены по цифровому отпечатку строки — SHA-256. Затем повторяется один порядок назначения: три записи в обучение, одна в валидацию, одна в тест. Получаются 89, 29 и 28 строк. Эти числа относятся к нашему способу подготовки; все наборы на свете по ним делить не требуется.
Отпечаток нужен для воспроизводимого порядка, а не для оценки хорошего цветка. У той же строки он будет тем же. Поскольку сначала мы свели повторы, одинаковая полная запись не может попасть сразу в две части. Между получившимися файлами таких совпадений нет.
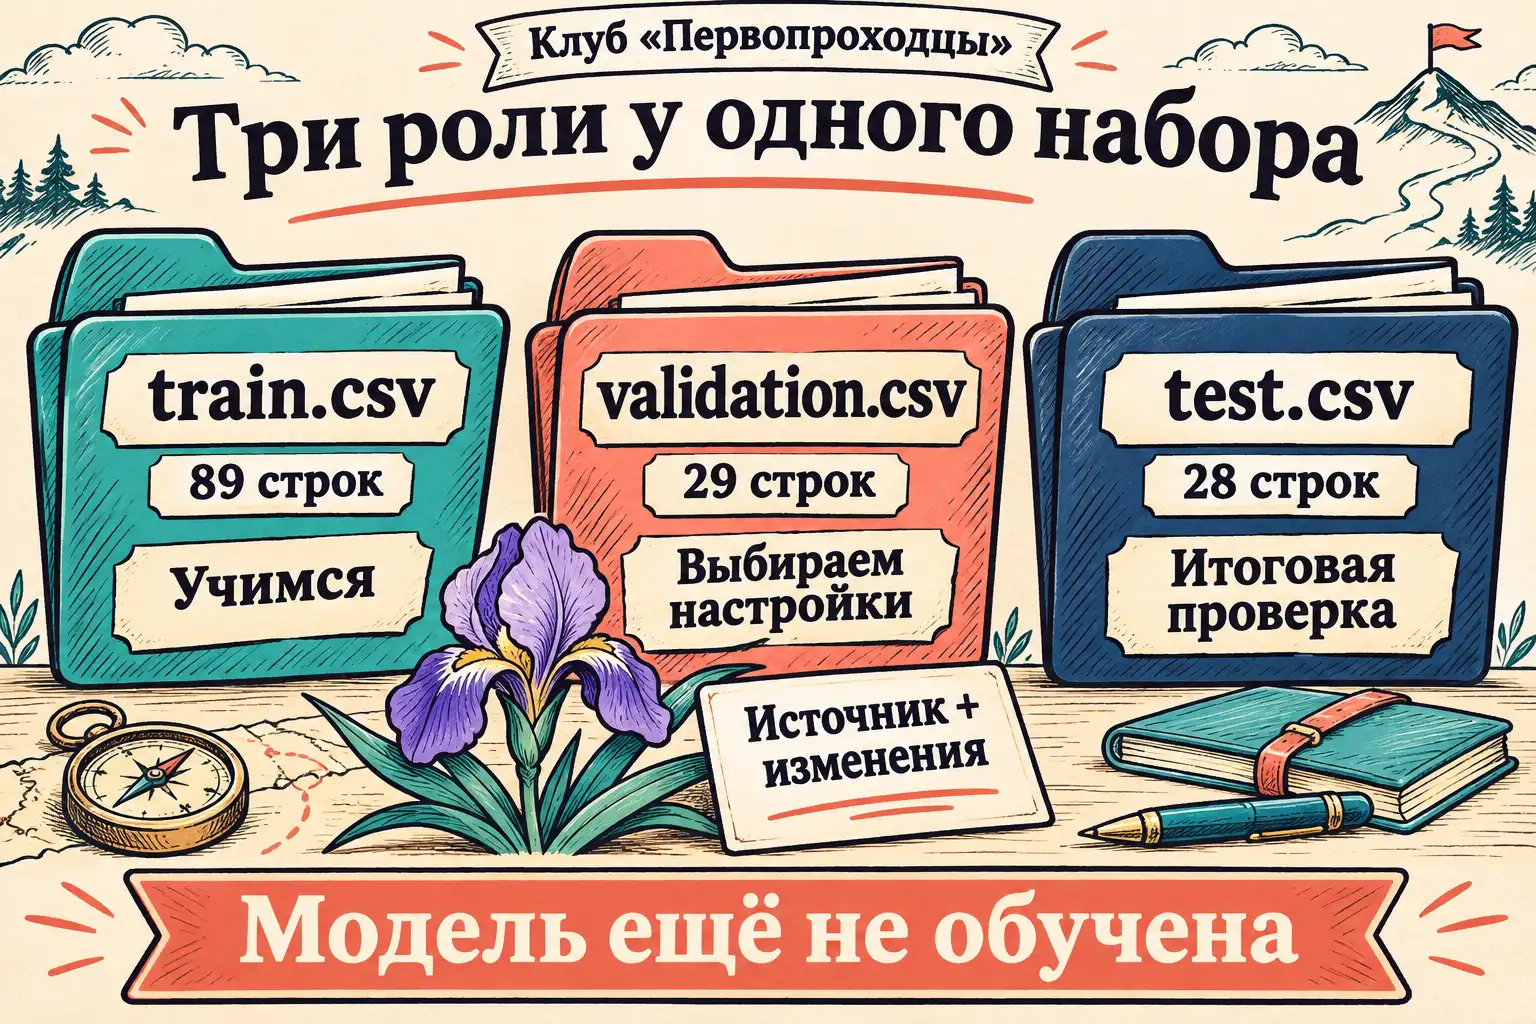
Числа показывают подготовленные строки, без заголовков. Они ничего не сообщают о точности будущей модели.
Получаем CSV и сохраняем записку о подготовке
Для повторения разбиения ниже есть готовая небольшая программа. Она читает сохранённый iris.csv, проверяет четыре размера, сводит одинаковые записи, исключает названную спорную группу и создаёт папку prepared с тремя файлами. Сам исходник остаётся на месте. Программа рассчитана на этот конкретный файл UCI.
Для запуска нужен установленный Go с официального сайта. Если вы ещё не работали с ним, попросите помощника уточнить вашу систему и провести установку по одному действию. Затем создайте обычный текстовый файл prepare.go в той же папке, что и iris.csv, и вставьте в него код из раскрывающегося блока. Имя не должно заканчиваться на .txt.
Откройте терминал в этой папке. В Windows это может быть Windows Terminal или PowerShell, в macOS — «Терминал». Попросите помощника подсказать, как перейти именно в вашу папку. Команду вводят в строке терминала, не в чат и не в ячейку таблицы:
go run prepare.goВ ответ должны появиться строки train: 89, validation: 29, test: 28, а рядом — папка prepared. Если возникла ошибка, остановитесь на ней и передайте помощнику её текст вместе с названием системы. Уже написанную программу целиком заменять новым вариантом по догадке не нужно.
Код подготовки Iris: вставьте целиком в prepare.go
// Готовит три набора из сохранённого Iris; модель не обучает.
package main

import (
	"crypto/sha256"
	"encoding/csv"
	"fmt"
	"os"
	"sort"
	"strconv"
	"strings"
)

func check(err error) { if err != nil { panic(err) } }

func main() {
	f, err := os.Open("iris.csv"); check(err)
	rows, err := csv.NewReader(f).ReadAll(); check(err); check(f.Close())
	if len(rows) != 151 { panic("Ожидалось 150 наблюдений и заголовок") }
	groups := map[string][]string{}
	unique := map[string]bool{}
	for _, row := range rows[1:] {
		if len(row) != 5 { panic("Ожидалось пять полей") }
		for i := 0; i < 4; i++ {
			n, err := strconv.ParseFloat(row[i], 64); check(err)
			if n <= 0 { panic("Нужен положительный размер") }
			row[i] = strconv.FormatFloat(n, 'f', -1, 64)
		}
		key := strings.Join(row, "\t")
		if unique[key] { continue }; unique[key] = true
		if key == "4.9\t3.1\t1.5\t0.1\tIris-setosa" { continue }
		groups[row[4]] = append(groups[row[4]], key)
	}
	parts := map[string][][]string{"train": {}, "validation": {}, "test": {}}
	labels := []string{}; for label := range groups { labels = append(labels, label) }; sort.Strings(labels)
	for _, label := range labels {
		g := groups[label]
		sort.Slice(g, func(i, j int) bool { return fmt.Sprintf("%x", sha256.Sum256([]byte(g[i]))) < fmt.Sprintf("%x", sha256.Sum256([]byte(g[j]))) })
		for i, key := range g {
			part := "train"; if i%5 == 3 { part = "validation" }; if i%5 == 4 { part = "test" }
			parts[part] = append(parts[part], strings.Split(key, "\t"))
		}
	}
	check(os.MkdirAll("prepared", 0755))
	for _, name := range []string{"train", "validation", "test"} {
		f, err := os.Create("prepared/"+name+".csv"); check(err)
		w := csv.NewWriter(f); check(w.Write(rows[0])); check(w.WriteAll(parts[name])); w.Flush(); check(w.Error()); check(f.Close())
		fmt.Printf("%s: %d\n", name, len(parts[name]))
	}
	fmt.Printf("Исходных: %d; уникальных: %d; спорная группа исключена\n", len(rows)-1, len(unique))
}
Откройте три созданных CSV. Сначала посмотрите на заголовок: во всех файлах должны остаться те же пять полей. Затем проверьте, что числа не склеились с названиями классов в одну ячейку. Проверьте число записей без заголовка. В каждом файле есть все три класса; названия классов остались исходными. В программе не было шага обучения, поэтому оценки точности среди результатов нет.
Допишите к источник.txt: «Числа приведены к единой записи; одинаковые полные строки сведены; спорная группа со значениями из наблюдений 35 и 38 исключена целиком; уникальные строки разделены внутри классов по SHA-256 и циклу 3/1/1. Получены train 89, validation 29, test 28». Сохраните эту записку рядом с рабочими файлами.
Получившаяся папка уже рассказывает свою историю. Видно, откуда взят материал, что изменено и зачем существуют три части. Данные для обучения нейросети теперь можно передать себе будущему или другому человеку: записка ответит на вопросы раньше, чем начнут созваниваться владельцы таблиц.
Вопросы и ответы о подготовке набора
Можно взять для проверки те же строки, на которых учили?
Для итоговой оценки нужны отложенные примеры. Знакомые строки облегчают задачу и могут скрыть проблемы на новом материале. Сначала разделите набор, затем сохраняйте роли частей. Если постоянно выбирать настройки по тесту, он постепенно превращается ещё в одну подсказку при разработке.
Сколько примеров требуется для своей задачи?
Одного универсального числа нет. Важны разнообразие случаев, сложность задачи, качество ответов и выбранный способ обучения. Iris здесь помогает увидеть устройство подготовки. Для своих фотографий растений понадобятся изображения и условия съёмки, а четыре измерения из этой таблицы их не заменят.
Почему мы не исправили ошибки по подсказке источника?
Можно выбрать и исправление, сохранив точный журнал замен. Мы выбрали изоляцию всей совпадающей группы, чтобы явно отделить полученный оригинал от спорных значений. В другом проекте решение зависит от того, что известно о происхождении каждой записи.
Можно попросить нейросеть дописать недостающие строки?
Это уже создание искусственных примеров, со своими правилами и проверками. Для текущего разбора нужен настоящий внешний исходник. Если в нём не хватает важных случаев, сначала выясните, какие именно нужны и где их получить, сохраняя известные ответы и происхождение.
Что попробовать после сохранения файлов?
Попросите ИИ объяснить на одном цветке, какие признаки доступны до ответа и где будет проверяться результат. Затем можно переходить к отдельной задаче обучения простого классификатора. Начать с собственного небольшого материала поможет практика первых задач; в клубе можно продолжить работу и задать вопрос там, где застряли.
Зевс заселил остров по просьбе Эака за одну ночь. У нас чудо скромнее: несколько файлов, в которых каждый цветок занимает своё место. Зато на итоговый экзамен больше не придёт тот же муравей, трижды переодетый в ирис. Министерству придётся проверять знания по-настоящему.