У Свифта Гулливер хочет побеседовать с Гомером и Аристотелем, а вместе с ними прибывают сотни комментаторов. Для всех уже не хватает комнат. Вроде пригласили двоих, а дворец уже просит дополнительные стулья. В работе с моделью похожее удивление возникает, когда на экране всего две строки ответа, а счётчик сообщает о куда большем объёме.
Допустим, вы собираете друзей на совместное чтение. В чат ушли заметки: один свободен после шести, другой принесёт книгу, третий может только в субботу. Ниже вы добавили несколько вариантов места и попросили короткое приглашение. На выходе — карточка из пары предложений. Смотришь на неё и думаешь: куда в отчёте поместилась вся остальная компания?
Удобнее разложить задачу на три части: из каких единиц модель получает текст, что относится ко входу и что — к выходу. Затем прочитаем маленький отчёт с числами 100 и 30. После этого вы сможете объяснить его обычными словами и задать точный вопрос к своему сервису.
Что такое токены нейросети на русской фразе
Возьмём просьбу: «Позови друзей на чтение в субботу». Мы видим привычные слова и пробелы. Модель получает текст в своём представлении — последовательности единиц. Процесс такого преобразования называют токенизацией, а инструмент, который его выполняет, — токенизатором.
У единицы могут быть разные размеры. Где-то ей соответствует целое слово, где-то часть слова или знак. Поэтому, когда считают токены нейросети, обычное подчёркивание слов карандашом не заменяет нужного инструмента. Точное разбиение зависит от модели и её кодировки; его смотрят в совместимом счётчике.
Теперь изменим просьбу: «Позови 12 друзей на чтение в субботу, 14 ноября, к 18:30». Добавились количество, дата, время и знаки. Текст несёт больше условий, но точное новое число единиц мы всё равно не получим простым подсчётом слов. Сравнивать эти две строки полезно в одном токенизаторе с одной выбранной кодировкой.
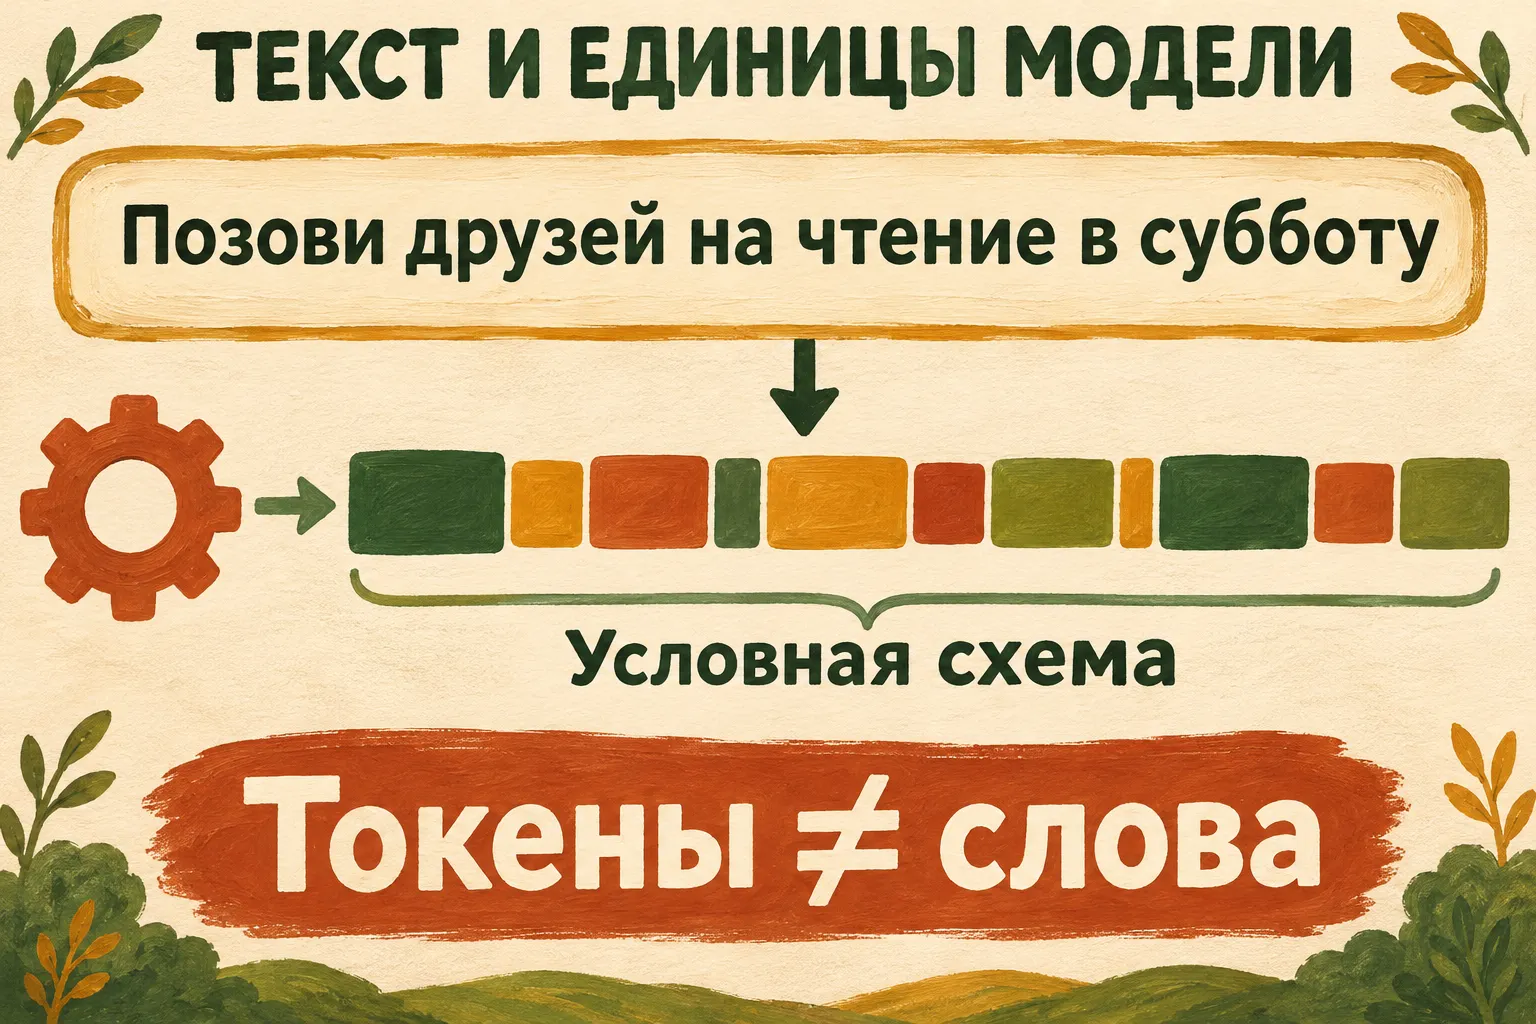 Цветные блоки объясняют принцип. Точное разбиение этой фразы и число единиц здесь не утверждаются.
Называть токены нейросети «кусочками текста» для первого знакомства удобно. Только размеры этих кусочков не обязаны совпадать с привычными словами. Представьте набор деталей разной формы: по числу целых предметов ещё нельзя узнать, сколько деталей понадобится для их сборки. Для русского текста особенно не стоит брать чужую приблизительную пропорцию из английского примера.
В справке OpenAI о токенах отдельно отмечены влияние языка, пробелов и кодировки. Английская оценка «около четырёх символов» относится к приблизительным прикидкам на английском; превращать её в точный счётчик русской фразы нельзя. Для нашей задачи достаточно помнить: слова и единицы модели считаются по разным правилам.
Вход и выход: кому досталась большая стопка
Входом называют материал, который передали модели в запросе. В нашем случае там есть просьба составить приглашение и заметки о встрече. Выходом становится то, что модель создаёт в ответ. Даже если приглашение получилось коротким, для его подготовки уже был передан исходный материал.
Вот почему токены нейросети нельзя оценивать только по видимому ответу. На столе у вас была толстая стопка заметок, а в результате появилась маленькая карточка. На карточке останутся место и время, а реплики участников могут исчезнуть. Но модель уже получила эти реплики, когда готовила приглашение. Так большой вход уживается с маленьким выходом — без загадочного превращения ста слов в тридцать.
Для разбора возьмём учебный отчёт, не измерение наших двух фраз:
{
  "input_tokens": 100,
  "output_tokens": 30,
  "total_tokens": 130
}
Его можно прочитать без программирования: модели передали 100 единиц, она создала 30, вместе получилось 130. Это не сообщение, что в просьбе было 100 слов, а в приглашении 30. Числа относятся к единицам модели.
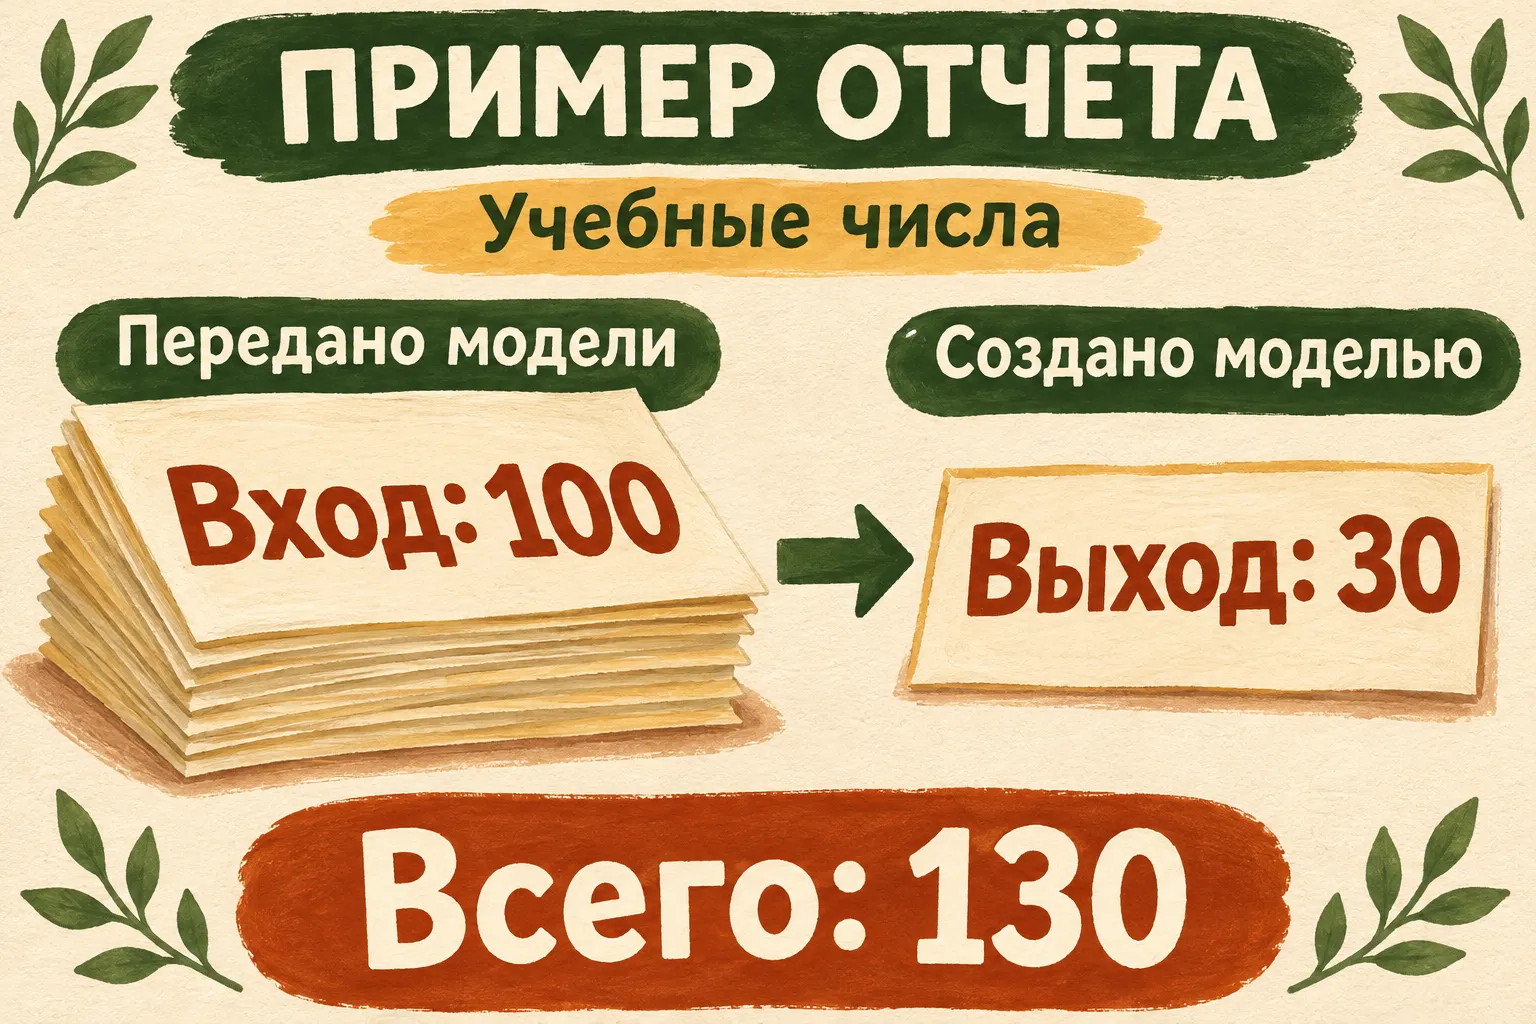 Вход и выход складываются: 100 + 30 = 130. Эти заданные числа поясняют поля отчёта.
| Поле нашего отчёта | Как прочитать | Что с ним сравнивать |
|---|---|---|
| input_tokens:100 | Передано модели | Состав запроса и переданного материала |
| output_tokens:30 | Создано моделью | Выход модели, с учётом правил её отчёта |
| total_tokens:130 | Общий объём | Итог входа и выхода в этом примере |
Названия полей зависят от интерфейса. Например, в Chat Completions у DeepSeek используются prompt_tokens для входа и completion_tokens для выхода, а общий итог называется total_tokens. Соответствие описано в документации DeepSeek. Если перед вами другие подписи, сначала найдите их определения в справке именно этого способа доступа.
Понимание, как устроены токены нейросети, начинается с такой привязки. Не нужно заранее учить весь формат ответа. Найдите три поля, подпишите их по-русски и проверьте, к какому запросу относится отчёт. Уже этого достаточно, чтобы перестать сравнивать вход с длиной одной карточки.
Почему итог больше, чем последняя просьба
Представим два способа составить приглашение. В первом вы пишете только: «Позови друзей в субботу к шести». Во втором добавляете заметки всех участников и просите согласовать время по ним. Обе попытки могут закончиться похожими двумя строками. Но объём переданного материала у них разный.
Кроме видимого текста просьбы, полный запрос может содержать историю переписки, инструкции и другие данные. Какие именно части сервис отправляет модели, зависит от его устройства. Поэтому счётчик для голой фразы и отчёт целого запроса отвечают на разные вопросы. Важен состав того, что действительно было передано.
Если токены нейросети посчитаны неожиданно щедро, начните с простого вопроса: «В этом отчёте только моя строка или весь запрос?» Затем выясните, включена ли предыдущая переписка и приложенный материал. Не обязательно что-то немедленно удалять. Сначала полезно понять, какие части помогают получить нужное приглашение.
В заметках может оказаться десять вариантов даты, хотя субботу уже выбрали. Их можно заменить одной ясной фразой. А просьбу учесть дорогу участника лучше оставить: она меняет подходящее время встречи. Если вычеркнуть всё длинное без разбора, помощник составит экономное приглашение, на которое кто-то не успеет. Сначала сохраняем нужное условие и только потом убираем лишние обсуждения.
Когда нужно точно посчитать токены нейросети в обычном тексте, используйте токенизатор выбранной модели. Для фактического расхода запроса смотрят возвращённые сведения usage, если этот способ доступа их предоставляет. В пояснении DeepSeek также предлагается ориентироваться на фактический отчёт. Примерное соотношение букв и единиц помогает прикинуть порядок величины, но точным измерением не становится.
Подкатегории: ещё раз прибавлять не надо
В более подробном отчёте рядом с общими полями могут быть строки про кэш и рассуждение. Кэш означает повторное использование части входа. Рассуждение — дополнительные единицы, которые соответствующая модель использует при подготовке ответа. Устройство и состав этих полей зависят от конкретного API и модели.
Возьмём ещё один учебный пример. Вход равен 100, из них 40 относятся к кэшу. Выход равен 30, из них 10 относятся к рассуждению. Входные 40 уже содержатся в 100, выходные 10 — в 30. Если сложить 100+30+40+10, одни и те же части окажутся учтены дважды. Итог этого примера остаётся 130.
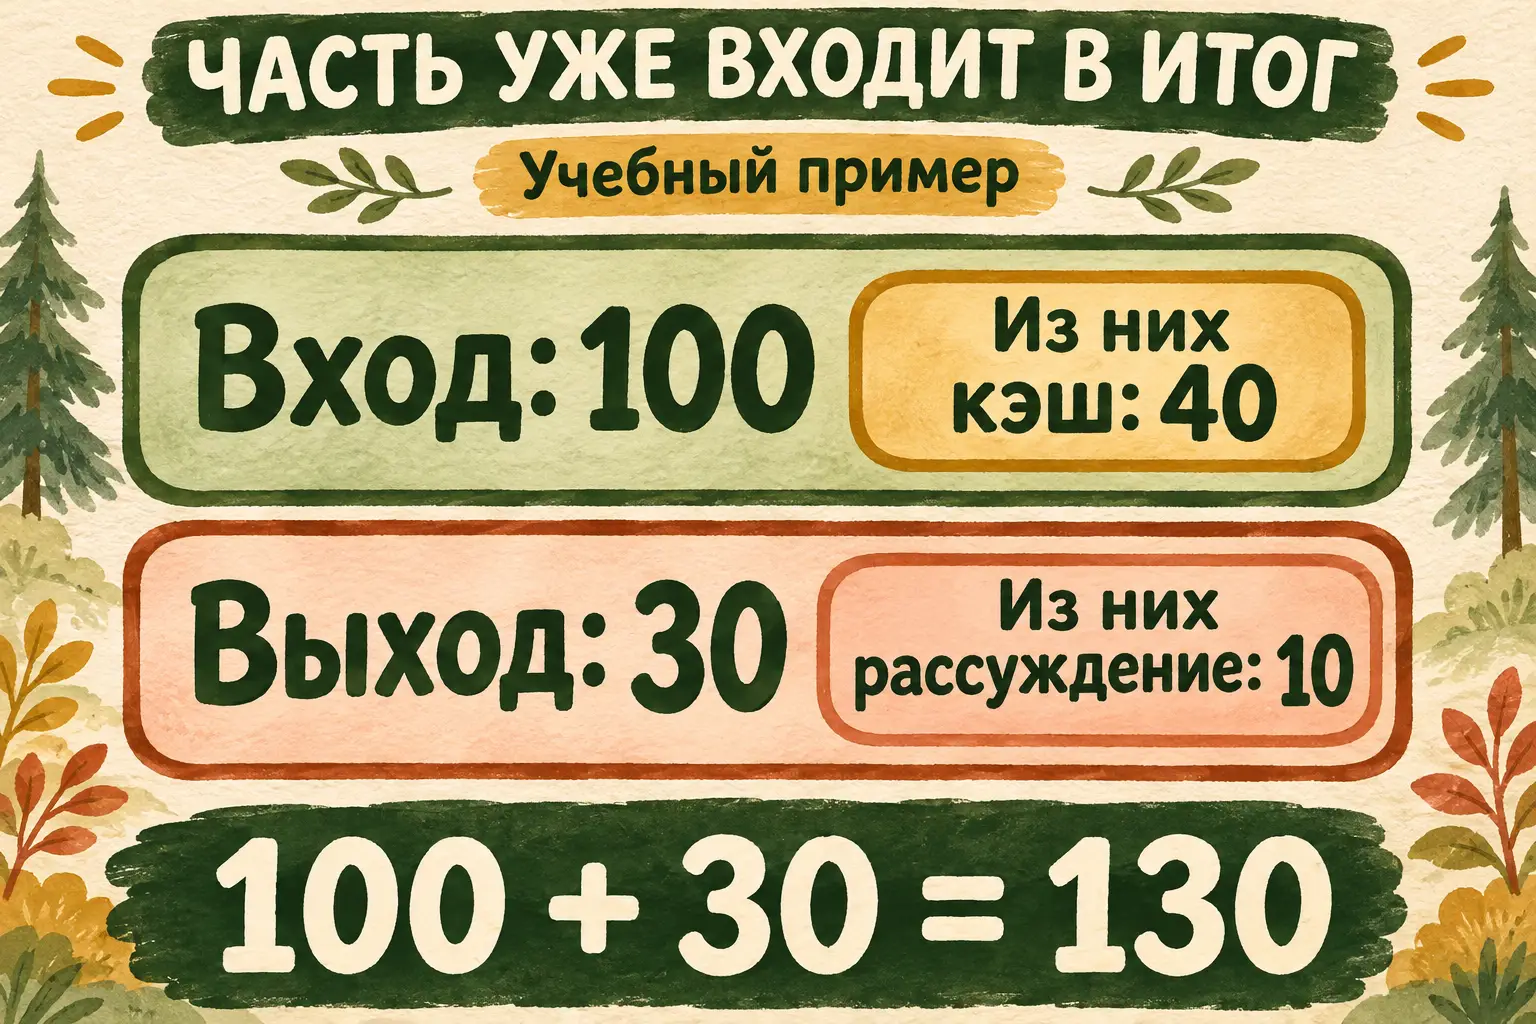 Словосочетание «из них» здесь важнее отдельных цифр: вложенные категории уже входят в свой итог.
Это ещё одна причина, почему токены нейросети не всегда можно восстановить по длине видимого ответа. В отчёте модели с рассуждением выход может включать больше, чем текст итогового приглашения. Сначала читаем описание поля, затем решаем, с какой частью результата его сравнивать.
Если отчёт вашего сервиса устроен иначе, не переносите пример по похожему названию. Сверьте, что считается общим полем, а что его детализацией. Достаточно найти определение нужной строки; весь справочник разработчика ради этого изучать не требуется.
ИИ поможет перевести свой отчёт на обычный язык
Откройте DeepSeek и вставьте названия полей и числа из доступного вам отчёта. Можно начать с нашего примера, не подключая программный доступ. Запрос такой:
Хочу понять отчёт о расходе: input_tokens: 100, output_tokens: 30, total_tokens: 130. Объясни, что передано модели, что создано ею и почему число слов может быть другим. Это учебные числа. Не выдавай свою прикидку за точную токенизацию моей фразы. Затем помоги прочитать мой настоящий фрагмент отчёта: сначала уточни сервис и способ доступа, а если значение поля зависит от документации, сверь её при наличии поиска или попроси нужный фрагмент справки. Задавай по одному вопросу.
Подойдёт и привычный ChatGPT или Claude. Нужна беседа о полях, а не покупка нового доступа. Если токены нейросети скрыты за лимитом обычного чата и подробного отчёта нет, так и запишите: точный расход здесь не виден. Помощник может объяснить единицу, но его ответ о собственном точном числе не заменяет счётчик сервиса.
Когда захотите показать реальный фрагмент, достаточно полей расхода. Ключи доступа, личные сообщения и содержимое закрытых документов для этого не нужны. Сохраните рядом простую расшифровку: вход — столько-то, выход — столько-то, общий итог — такой-то. Отдельно подпишите вложенные строки словами «из них». Когда позже откроете тот же отчёт, не придётся снова выяснять, почему кэш не прибавляется к уже указанному входу.
Слова, кредиты и токены: что написано на кнопке
У генератора видео может быть собственный пакет кредитов, у текстового API — учёт единиц модели, у обычного чата — лимит сообщений. Если все эти вещи в разговоре называют одним словом, сравнивать числа становится трудно. Начните с определения единицы в условиях выбранного сервиса.
В этой статье токены нейросети означают единицы представления и обработки текста. Из цены за них в API нельзя вывести стоимость подписки в обычном чате. Точно так же число кредитов видеосервиса само по себе не сообщает, сколько текстовых единиц получила языковая модель.
Покупать что-либо для понимания нашего отчёта не нужно. Если позже вы захотите оценить стоимость своей задачи через API, понадобятся актуальные правила оплаты именно этой модели и категорий расхода. Сейчас мы уже умеем читать числа, к которым эти правила будут применяться.
Вопросы и ответы о токенах
Можно считать по пробелам?
Так можно приблизительно посчитать слова. У единиц модели другие границы, зависящие от токенизатора. Для точного значения используйте совместимый счётчик или фактический отчёт запроса.
Время 18:30 считается одним токеном?
Это зависит от выбранной кодировки. Мы видим знакомую запись времени, а её разбиение нужно смотреть в нужном инструменте. По внешнему виду строки точное число не назначаем.
Почему одинаковая фраза дала разные числа?
Сверьте модель и кодировку, сами пробелы и знаки, а затем состав полного запроса. Возможно, сравнили счётчик отдельной строки с отчётом, куда вошла история. Условия измерения должны совпадать.
Чем токены нейросети отличаются от контекстного окна?
Первое — единицы, второе — ограничение объёма, с которым модель работает. Разбор длинного источника и распределение материала по запросам — следующий отдельный вопрос. Здесь наш результат проще: различить вход, выход и общий итог одного отчёта.
Приглашение может оставаться коротким
Когда поля перестают выглядеть загадочными, проще ставить собственные задачи: попросить письмо, разобраться в заметках, сократить готовый текст, не выбросив важное. Для следующего шага пригодится способ сформулировать задачу помощнику. А знакомство с практикой «Первопроходцев» поможет выбрать направление для своих материалов. В клубе можно задавать вопросы и дорабатывать проекты; раз в две недели проходят эфиры, Никита лично проверяет проектные работы. Условия участия — на странице клуба.
Оставьте себе три подписи к отчёту и две русские фразы для сравнения. Короткое приглашение может так и остаться коротким, хотя перед ним модель получила целую компанию заметок. Гомер с Аристотелем помещаются за столом. Комментаторов пересчитаем отдельно — и второй раз в общий итог приглашать не будем.