У Куна Теламон первым взбирается на стену Трои и сердит этим Геракла. Тот уже выхватил меч, а Теламон быстро собирает камни: видите ли, строит жертвенник Гераклу-победителю. Ответ спас положение и, вероятно, самого строителя. Нашим анкетам такой дипломатии не потребуется. В них уже записано, что выбрали люди; осталось разобраться с итогом, который неожиданно добрался до 125%.
Представим небольшую встречу в библиотеке, где собираются поговорить об ИИ. На столе уже пять коротких анкет. Вы раскладываете их рядом: в одной два применения, в другой явное «Ни для чего», дальше пустое поле. Из этих карточек нужно сделать сводку, которую завтра можно открыть перед встречей и сразу понять.
Для статьи возьмём придуманный исходник из пяти анкет. Сначала передадим его Алисе целиком, затем сопоставим ответ с расчётом ниже. Вопросы сочинять уже не нужно: мы разбираем полученные ответы и проверяем, что именно оказалось в каждом проценте.
Как применить нейросеть для анализа опросов к готовым ответам
У нас два независимых вопроса. В первом — «Пробовал ИИ?» — выбирают один ответ. Во втором — «Для чего?» — можно отметить несколько вариантов. Каждый вопрос считаем по его собственным заполненным ответам.
Назовём анкеты R1–R5. Это условные имена, которые помогают вернуться к конкретной строке; никаких имён людей для подсчёта не понадобится. Особенность исходника оговорим сразу: у R3 во втором вопросе стоит явное «Ни для чего». У R5 там пропуск — ответа нет.
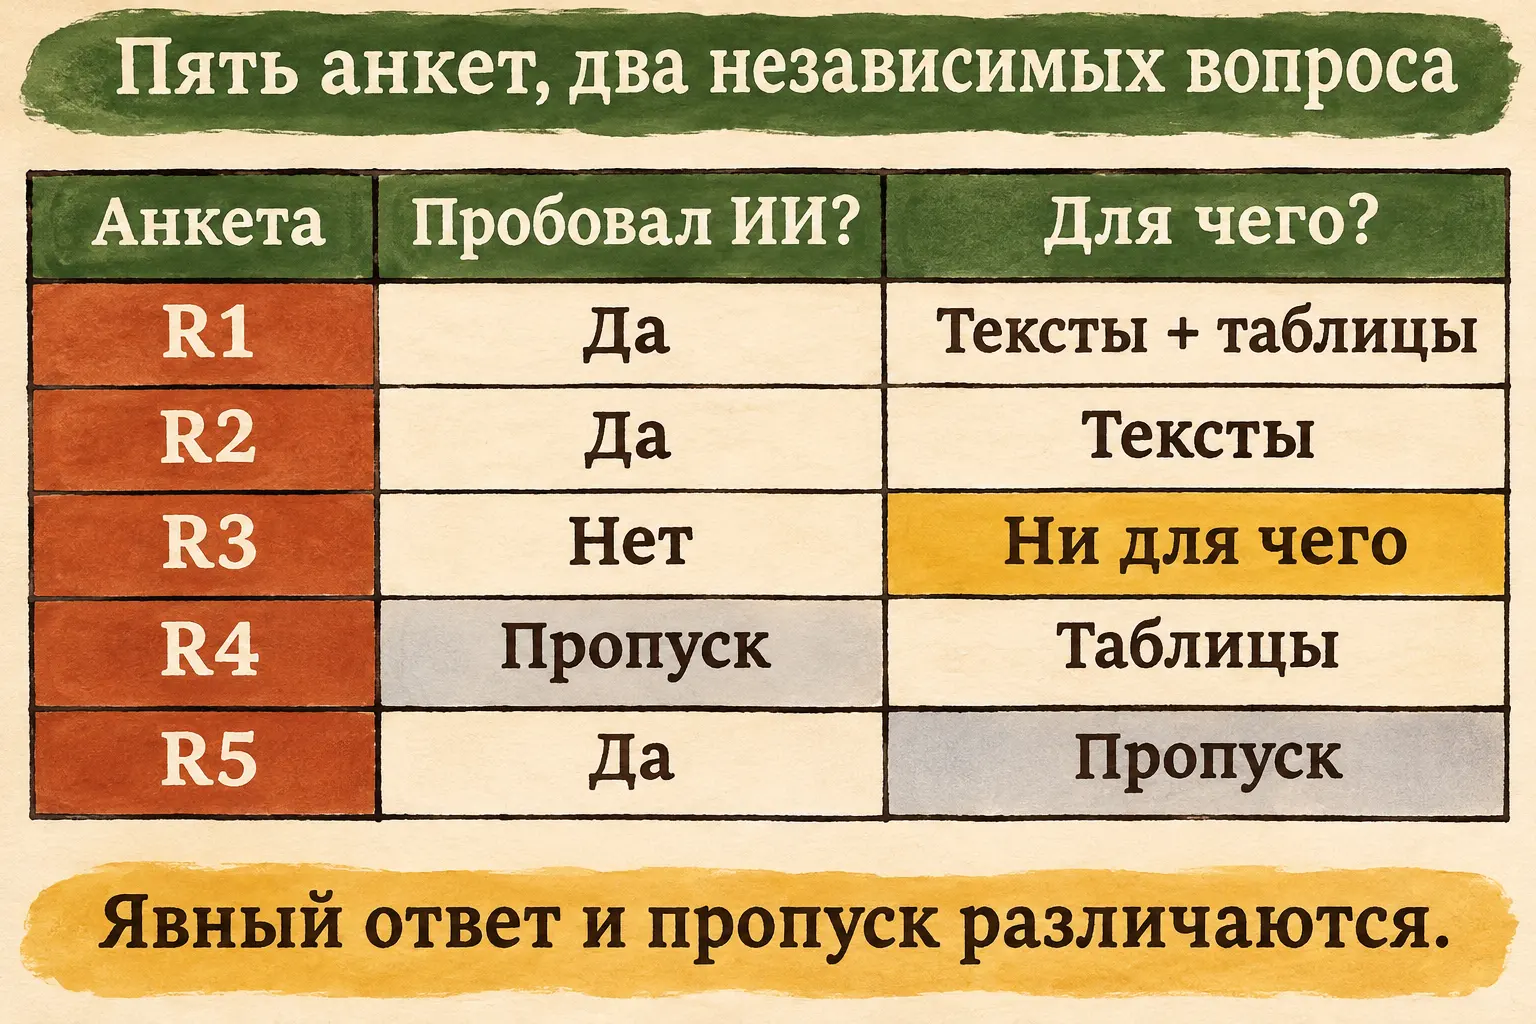 Исходник примера: охрой выделен ответ «Ни для чего», серым — пропуски. Вопросы независимы, поэтому ответы одного не подставляются в другой.
Скопируйте в чат весь набор вместе с пояснением:
Разбери этот анонимный опрос. Всего 5 анкет, R1–R5.
Других анкет в примере нет. Вопросы независимы.

Вопрос 1: «Пробовал ИИ?» — один вариант ответа.
R1: Да
R2: Да
R3: Нет
R4: пропуск
R5: Да

Вопрос 2: «Для чего?» — несколько вариантов ответа.
R1: тексты и таблицы
R2: тексты
R3: Ни для чего — явный ответ
R4: таблицы
R5: пропуск, нет ответа

«Ни для чего» не означает пропуск.
Причины ответов и пропусков неизвестны.
Перед отправкой найдите в исходнике две соседние по смыслу записи: R3 сообщил «Ни для чего», а R5 оставил второй вопрос пустым. Поставьте рядом с собой обе карточки. Эта маленькая разница понадобится сразу в двух местах: при подсчёте ответивших и при проверке доли «Ни для чего».
Отправить Алисе запрос на подсчёт
Откройте alice.yandex.ru и начните отдельный чат для опроса. Если потребуется вход, используйте свой Яндекс ID. Вставьте исходник в поле сообщения и добавьте под ним запрос:
Посчитай распределения двух вопросов. Покажи число всех анкет, ответивших на каждый вопрос и пропусков. Для вопроса 2 долю считай от ответивших людей, не от суммы отметок. Поясни, почему суммы долей не обязаны равняться 100%. Приведи R1–R5 для каждого подсчёта, не делай вывода о рынке и причинах. Ответ дай короткой сводкой с основаниями: кого ты включил в каждое число.
Отправьте сообщение и дождитесь сводки. В ней должны появиться итоги по каждому вопросу, пропуски и номера анкет, на которых основан подсчёт. Текстовый диалог и продолжение разговора описаны в справке Яндекса. Особые режимы и платная опция для первого текстового шага условием не являются; у расширенных функций есть собственные условия доступности.
Если в окне чата трудно найти поле сообщения, попросите помощи одной фразой: «Хочу передать тебе пять коротких анкет. Я на компьютере. Уточни, что у меня открыто, затем дай одно действие: куда вставить текст и что должно получиться. Жди моего ответа». Опишите окно в ответ на вопрос, а когда материал окажется в диалоге, переходите к подсчёту.
При затруднении с самими числами задайте предметный вопрос: «Покажи только, кто ответил на первый вопрос, а кто его пропустил». Такой промежуточный результат легко сопоставить с исходником, прежде чем читать проценты.
Пять анкет и четверо ответивших
На первый вопрос ответили R1, R2, R3 и R5. У R4 пропуск. Значит, ответы «Да» и «Нет» распределяем между четырьмя ответившими людьми. «Да» выбрали R1, R2 и R5 — трое из четырёх, 75%. «Нет» выбрал R3 — один из четырёх, 25%.
Пропуск показывает другую долю: одна анкета из пяти, 20%. Здесь мы смотрим на весь полученный набор и спрашиваем, в какой его части нет ответа. Этот процент стоит отдельно от распределения «Да/Нет» среди ответивших.
| Первый вопрос | Анкеты | Подсчёт |
|---|---|---|
| Да | R1, R2, R5 | 3 из 4 ответивших = 75% |
| Нет | R3 | 1 из 4 ответивших = 25% |
| Пропуск | R4 | 1 из 5 всех анкет = 20% |
Прочитайте первую итоговую строку полностью: «Да — трое из четырёх ответивших, 75%». Процент теперь держится на видимых R1, R2 и R5. Если завтра сводку откроет другой человек, ему останется заглянуть в эти три анкеты. В готовую заметку переносите всю эту подпись: всех участников у нас пятеро, а здесь речь о тех, кто заполнил первый вопрос.
Можно выбрать и другой расчёт, например долю «Да» среди всех пяти анкет. Но это будет отдельный показатель с другим знаменателем. Сейчас сохраняем заданный путь: варианты — среди ответивших, пропуски — среди всех полученных анкет.
На второй вопрос ответили тоже четверо — но другие
Вопрос «Для чего?» заполнили R1, R2, R3 и R4. R5 его пропустил. В числе ответивших снова четыре человека, хотя состав отличается от первого вопроса.
R4 пропустил первый вопрос, зато выбрал таблицы во втором. Сохраняем обе записи как они есть. Не нужно заменять его явный выбор пропуском только потому, что в соседнем поле пусто. Независимость вопросов уже названа в исходнике.
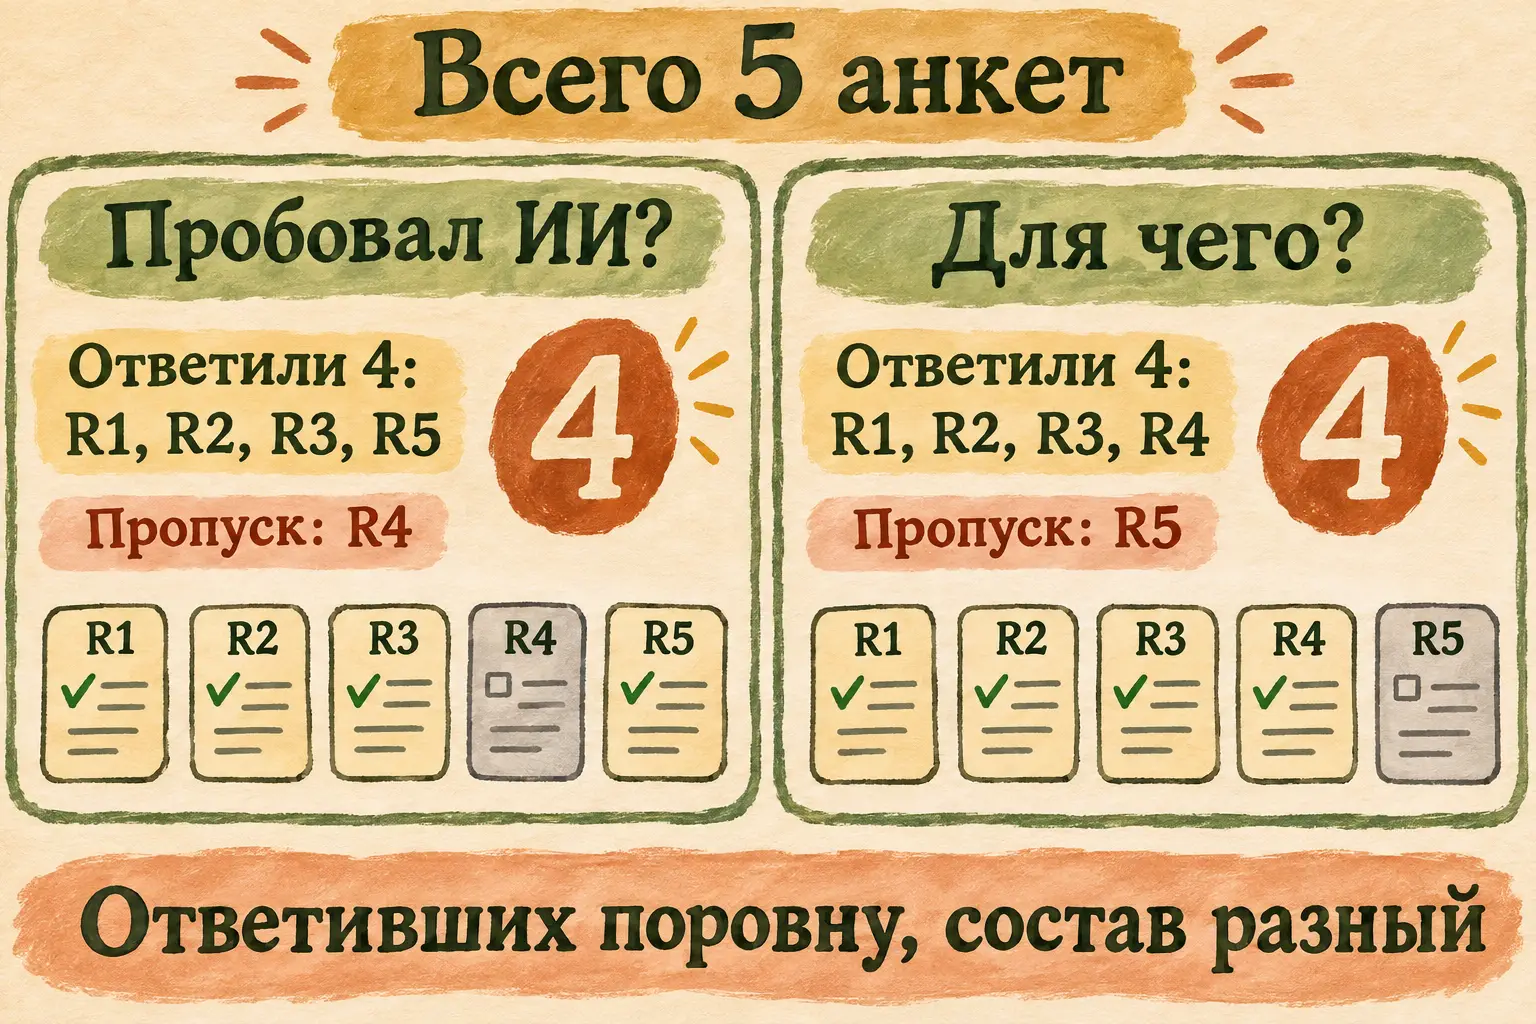 Сверка состава: число ответивших одинаковое, номера анкет различаются. Перед расчётом долей полезно перечислить их отдельно для каждого вопроса.
Вернитесь к R3. Человек выбрал «Ни для чего», и его ответ тоже должен остаться видимым в общем результате. Если он прочитает сводку, там найдётся его вариант. По правилам набора R3 входит в четырёх ответивших на второй вопрос. У R5 другое положение: ответа нет, это отдельно показанный пропуск.
Если у вашего реального опроса пустые клетки, сначала выясните, как форма различала явное «ничего» и отсутствие ответа. Для нашего исходника это различие уже указано, и его нужно сохранить в сводке.
Откуда взялись 125%
Тексты выбрали R1 и R2 — двое из четырёх ответивших, 50%. Таблицы выбрали R1 и R4 — двое из четырёх, тоже 50%. «Ни для чего» указал R3 — один из четырёх, 25%. Пропуск R5 составляет одну из пяти анкет, 20%, и показывается отдельно.
R1 одновременно входит в две первые группы. Один и тот же человек сообщил о двух применениях, поэтому при суммировании долей вариантов его учитывают дважды. Получается 50% + 50% + 25% = 125%. Для вопроса с несколькими вариантами это соответствует исходным ответам.
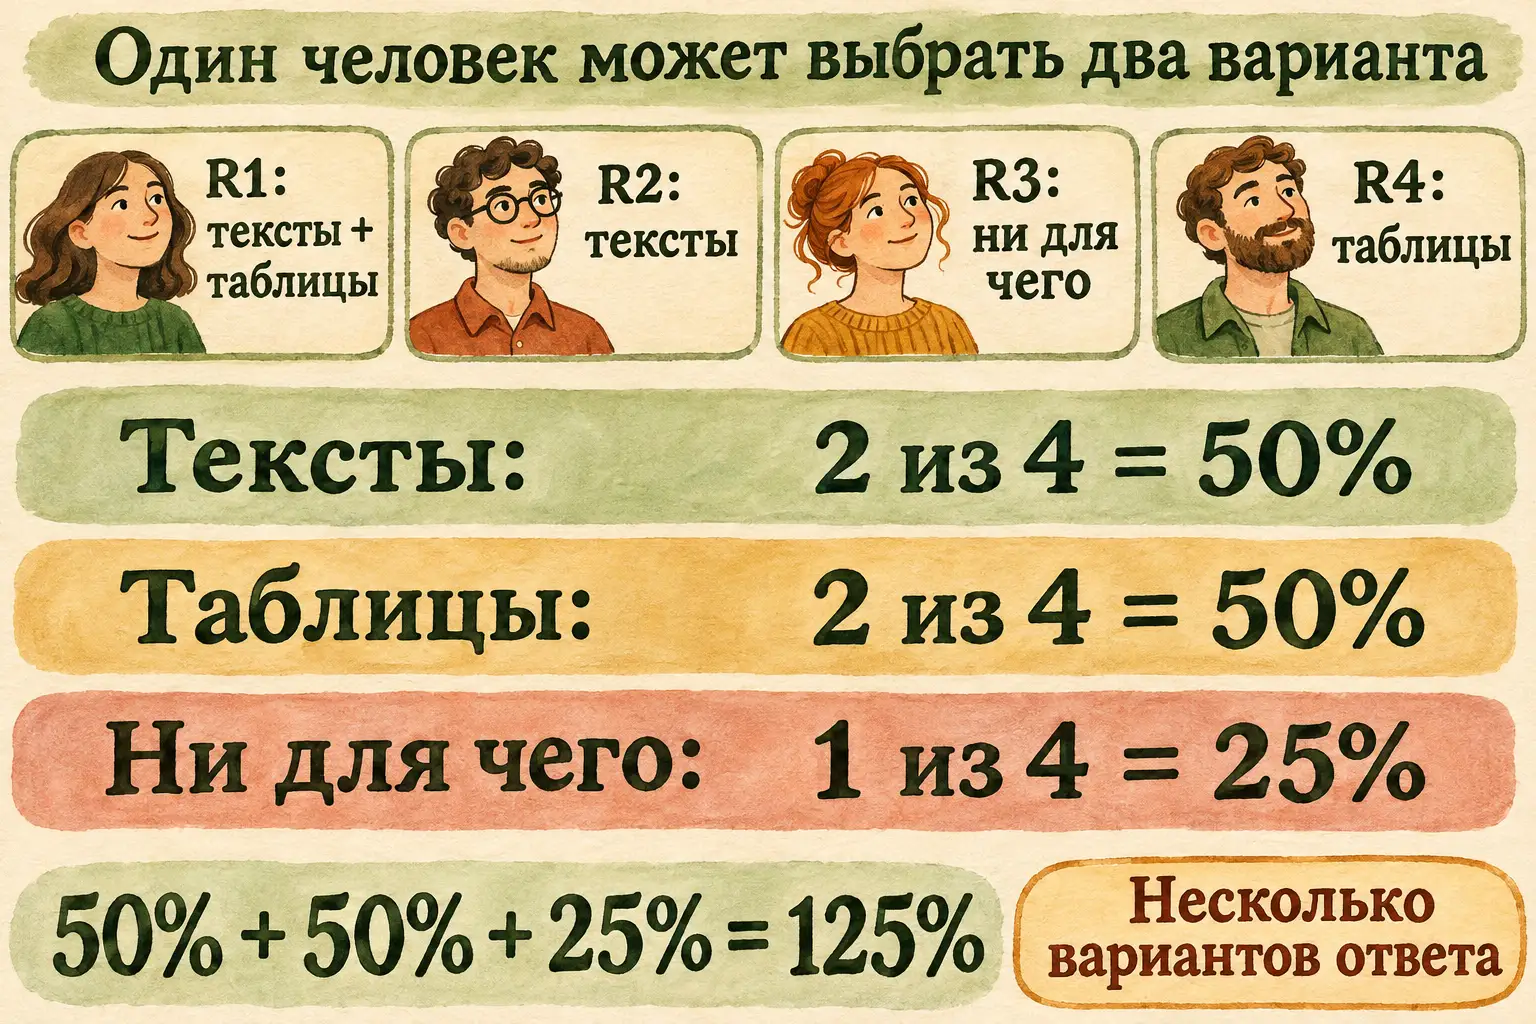 Знаменатель каждой доли — четыре ответивших человека. R1 входит в группы «тексты» и «таблицы», поэтому суммы долей не обязаны давать 100%.
Теперь откройте R1 и прочтите второе поле: «тексты и таблицы». Проведите две линии в своей сверке: одна идёт к текстам, другая к таблицам. Обе начинаются у одной анкеты. Вы увидели пересечение групп и можете объяснить его без дополнительных формул.
В библиотеке это вполне привычная история: читатель может одновременно взять роман Достоевского и справочник Excel. На вопрос «Что читаете?» получатся два ответа от одного человека. В нашей анкете R1 точно так же выбрал два применения.
Сумма всех отметок вариантов отвечает на отдельный вопрос — как распределены именно отметки. Мы же выясняем долю людей, выбравших каждый вариант. Поэтому в нашем отчёте знаменатель четыре, а не количество всех упоминаний применений. Проверить этот смысл можно прямо в запросе и в подписи к итогу.
Сверить сводку и сохранить понятную версию
Ниже — редакторский расчёт по исходнику статьи, с которым можно сопоставить ответ Алисы. Это наша сверка, а не цитата из ответа сервиса:
Всего получено 5 анкет. На вопрос «Пробовал ИИ?» ответили 4: «Да» — R1, R2, R5, или 75% ответивших; «Нет» — R3, или 25%. Пропуск R4 — 20% всех анкет. На вопрос «Для чего?» ответили 4: тексты — R1 и R2, 50%; таблицы — R1 и R4, 50%; «Ни для чего» — R3, 25%. Пропуск R5 — 20% всех анкет. Доли второго вопроса рассчитаны от ответивших людей; сумма 125% возникает из-за нескольких вариантов у R1.
Пройдите по номерам. Сначала проверьте количество всех анкет, затем состав ответивших, потом группы вариантов. После этого каждый процент получается из уже понятных чисел. Если группа текстов названа верно, а её доля отличается, вы сразу знаете, где проверить знаменатель. Если не сходится сам перечень людей, возвращайтесь к строкам анкет. У исправления появится точный адрес.
Если Алиса включила R5 во второй знаменатель, уточните:
Пересчитай второй вопрос. R5 его пропустил. Ответили R1, R2, R3 и R4. У R3 явное «Ни для чего», это ответ. Для каждого варианта покажи номера людей и долю от этих четырёх ответивших. Пропуск посчитай отдельно от всех пяти анкет.
Если ответ требует привести сумму вариантов к 100%, укажите на R1: «Второй вопрос допускает несколько вариантов. R1 выбрал тексты и таблицы. Сохрани его в обеих группах и объясни сумму долей людей». Важно исправить конкретное правило подсчёта, а затем снова сравнить итог с исходником.
В советах Яндекса по запросам есть продолжение работы через обратную связь. Здесь для этого уже приготовлен адрес ошибки: вопрос, номер анкеты и правило. Если трудно сформулировать своё уточнение, пригодится запрос под конкретную задачу.
Под ответом Алисы можно нажать значок копирования и вставить текст в заметку или документ. Оставьте первоначальный ответ отдельно. Проверенный вариант назовите так, чтобы узнать его среди заметок, и сохраните рядом исходник с R1–R5 и подписями знаменателей. На следующей встрече можно будет открыть эту пару: исходные карточки показывают сказанное людьми, короткая сводка помогает его обсудить.
Вопросы и ответы о долях и пропусках
Почему «Ни для чего» учитывается в ответивших?
В нашем наборе это явный вариант, у которого есть смысл. R3 ответил на вопрос, хотя не выбрал тексты или таблицы. Пустое поле R5 ничего об использовании не сообщает. Поэтому эти две записи оказываются в разных частях сводки.
Можно ли делить варианты на все анкеты?
Можно поставить и такой вопрос. Тогда рядом с результатом пишут «среди всех полученных анкет», а пропуски остаются видимыми. В статье мы выбрали распределение среди ответивших на конкретный вопрос. Главное — сохранить выбранный знаменатель в расчёте, запросе и подписи к проценту.
Нужно ли объяснять, почему R4 пропустил первый вопрос?
Причина в исходнике не указана. В сводке покажите пропуск R4 и сохраните его ответ про таблицы во втором вопросе. Тогда из отчёта будет видно, что для разбора уже есть, а что ещё можно уточнить. Если мотив понадобится для следующего решения, спросите человека или обратитесь к дополнительной записи, где он его объяснил.
Можно ли по этим ответам судить о всех читателях библиотеки?
Сводка описывает полученные пять анкет. Для решения внутри этой небольшой встречи уже видно, какие варианты отметили её участники. Более широкий вопрос потребует другого набора и способа его получения; здесь сохраняем масштаб переданного материала.
Какой результат можно считать готовым?
По каждому вопросу названы ответившие и пропуски, проценты сопровождаются знаменателями, R3 не исчезает из-за ответа «Ни для чего», а R1 остаётся в обеих выбранных группах. Вы можете показать любую строку отчёта и найти её основание в исходнике.
Пять карточек складываются в ясную картину
Нейросеть для анализа опросов помогает пройти от коротких записей к сводке, которую удобно прочитать и обсудить. На следующем собственном наборе сохраните тот же порядок: сначала люди и смысл полей, затем доли и проверка по строкам.
На странице практики с документами можно выбрать следующий шаг со своим материалом. В «Первопроходцах» такие задачи помогают постепенно освоить ИИ, задавать предметные вопросы и разбирать результат собственной работы.
Теламон сумел одним ответом изменить настроение Геракла. Нам хватило двух отметок в R1, чтобы объяснить 125%. Сохраните сводку рядом с анкетами. Когда на встрече спросят про лишние проценты, покажите первую карточку: там всё поместилось, даже без жертвенника.