Гулливер у Свифта попадает в лапы огромной обезьяны. Та принимает маленького человека за детёныша, гладит его и начинает кормить. Картина сложилась: ребёнок голоден, взрослый заботится. Возражения ребёнка только мешают обеду. Между тем у этого «ребёнка» есть профессия корабельного врача и собственное мнение о содержимом обезьяньих щёк.
В расшифровке бывает похожая уверенность. Надиктовали заметку о встрече с Ниной, открыли текст — и там ждёт Инна. Предложение аккуратное, запятая на месте, имя вполне человеческое. Даже стыдно придираться. Но в вашей записной книжке Нина есть, а Инна пока живёт исключительно в этом предложении.
Разобраться помогает простая привычка: отделять звук, который записался, от текста, который предложил ИИ. Тогда распознавание речи экономит труд, а исправлять приходится несколько конкретных мест вместо всей заметки.
Распознавание речи начинается со звука
Модель распознавания речи получает аудиофайл с меняющимся звуковым сигналом. Готовых букв, спрятанных между шорохами, в нём нет. Чтобы получить текст, программа извлекает из него признаки, с которыми умеет работать модель, а модель строит вероятную последовательность слов или частей слов.
Представьте короткое голосовое сообщение: «Нина, встречаемся пятнадцатого июня». Человек слышит знакомый голос, вспоминает разговор и догадывается, о какой встрече речь. Система распознавания речи получает запись и использует закономерности, которым научилась раньше. Наше знание о том, с кем мы договаривались, ей само по себе не передаётся.
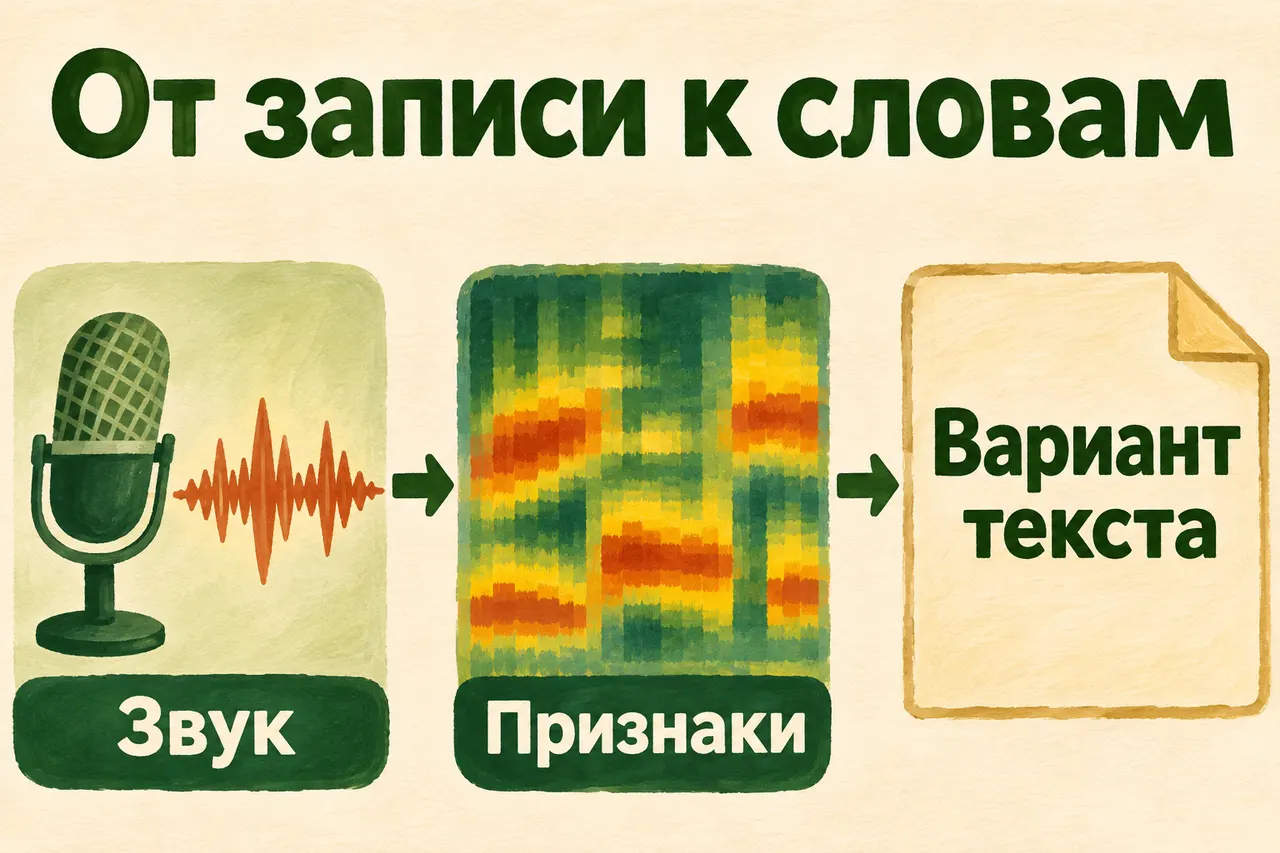
Упрощённая схема распознавания: результат справа остаётся вариантом прочтения записи.
Термин Speech-to-Text, или STT, буквально описывает этот переход: из речи в текст. Обозначение ASR означает автоматическое распознавание речи. Эти слова пригодятся в описаниях программ, но для первой проверки достаточно своей записи и возможности её прослушать. Базовое назначение технологии объясняет материал Сбера.
Откуда модель знает, как пишут услышанное
Один из способов обучать распознаванию речи — показывать модели много примеров, где аудио сопровождается соответствующим текстом. Предсказание сравнивают с текстовой опорой, а внутренние настройки постепенно меняют так, чтобы ошибок становилось меньше. После такого обучения модель использует найденные связи на новой записи.
Она усваивает и закономерности языка. В словах «встречаемся … июня» середина похожа на место для даты. Соседние слова помогают связать услышанное. В обычной речи звуки сливаются, говорящий проглатывает окончания, кто-нибудь рядом двигает стул. Контекст выручает, но привычное сочетание может потеснить редкое имя. Вежливая фраза останется вежливой, просто гостя в ней переименуют.
Здесь легко вообразить маленького секретаря, который сначала безошибочно услышал каждый звук, затем переписал его буквами. Для всех современных систем такая картина слишком буквальна. Например, в описании архитектуры Whisper звук преобразуется в спектрограмму — представление того, как меняются частоты во времени, — а затем модель предсказывает текст. Отдельного обязательного этапа «готовая буква для каждого звука» в этом объяснении нет.
Для читателя важнее общий результат: распознавание речи соединяет сведения из аудио с выученными языковыми связями. Поэтому две похожие на слух последовательности могут превратиться в разные, совершенно гладкие фразы.
Два варианта одной заметки
Возьмём два возможных текста, специально придуманных для сравнения. Это не результаты испытания конкретного сервиса:
| Вариант | Текст | Что требует внимания |
|---|---|---|
| А | Нина, 15 июня | Имя и день встречи |
| Б | Инна, 5 июня | Другое имя и другой день |
Каждый вариант можно спокойно прочитать вслух. По одной грамматике выбрать между ними нельзя. Если в записи было «Нина, пятнадцатого июня», вариант А передаёт нужные сведения, а вариант Б меняет и адресата, и дату. Перенесите второй в календарь — и у ошибки появится собственный будильник. Пятого июня телефон торжественно начнёт собирать вас к женщине, с которой вы ни о чём не договаривались.
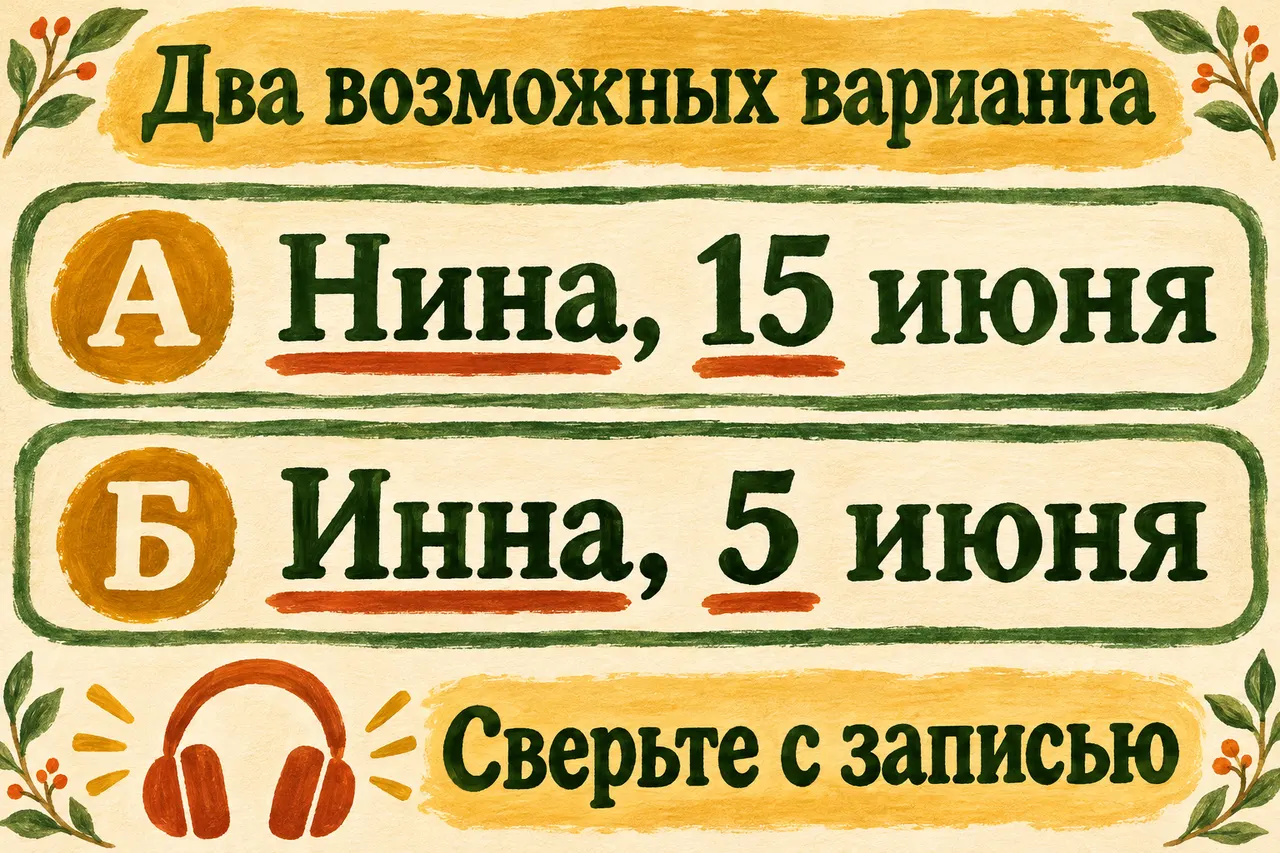
Сравнение показывает места для проверки, правильный вариант выбирают по аудио.
Сначала может захотеться вставить оба текста в чат и спросить: «Какой верный?» Помощник, которому дали только эти строки, способен объяснить различия. Установить по ним произнесённые слова он не сможет: самого звука в переписке нет.
Зато такое сравнение уже уменьшило задачу. Слушать нужно короткий участок с обращением и датой. Если вы точно знаете написание имени своей знакомой, это дополнительная опора для редактора. Если запись чужого рассказа и имя незнакомо, удобнее оставить пометку и спросить рассказчика. Так в семейной истории сохранится настоящий человек, пусть пока с вопросом возле фамилии.
Проверьте одну собственную запись
Проверять распознавание речи начните с фразы, для которой исходные слова вам известны. Можно записать собственную заметку с именем знакомого человека и датой выдуманной встречи. Встроенный диктофон телефона для этого подходит; способ получить саму расшифровку зависит от приложения, которое у вас уже есть.
Если инструмента ещё нет, выбор облачного или локального пути разобран в статье о расшифровке аудио. Здесь нам нужен уже полученный текст, чтобы понять механизм и проверить смысл.
Прослушайте запись один раз целиком. Затем читайте расшифровку и отмечайте места, где изменился участник, день, количество или действие. Особенно внимательно присмотритесь к короткому «не»: «позвонить» и «не позвонить» отправят вас в разные вечера. Пунктуацию пока можно оставить в покое: сначала вернём заметке её содержание.
Для первого опыта удобна такая последовательность:
- Найдите в тексте имя и число, если они есть в записи.
- Вернитесь к фрагменту, где они прозвучали, и прослушайте его отдельно.
- Исправьте слова, которые удалось уверенно расслышать.
- Неразборчивое место обозначьте как «неразборчиво» и сохраните рядом возможность вернуться к аудио.
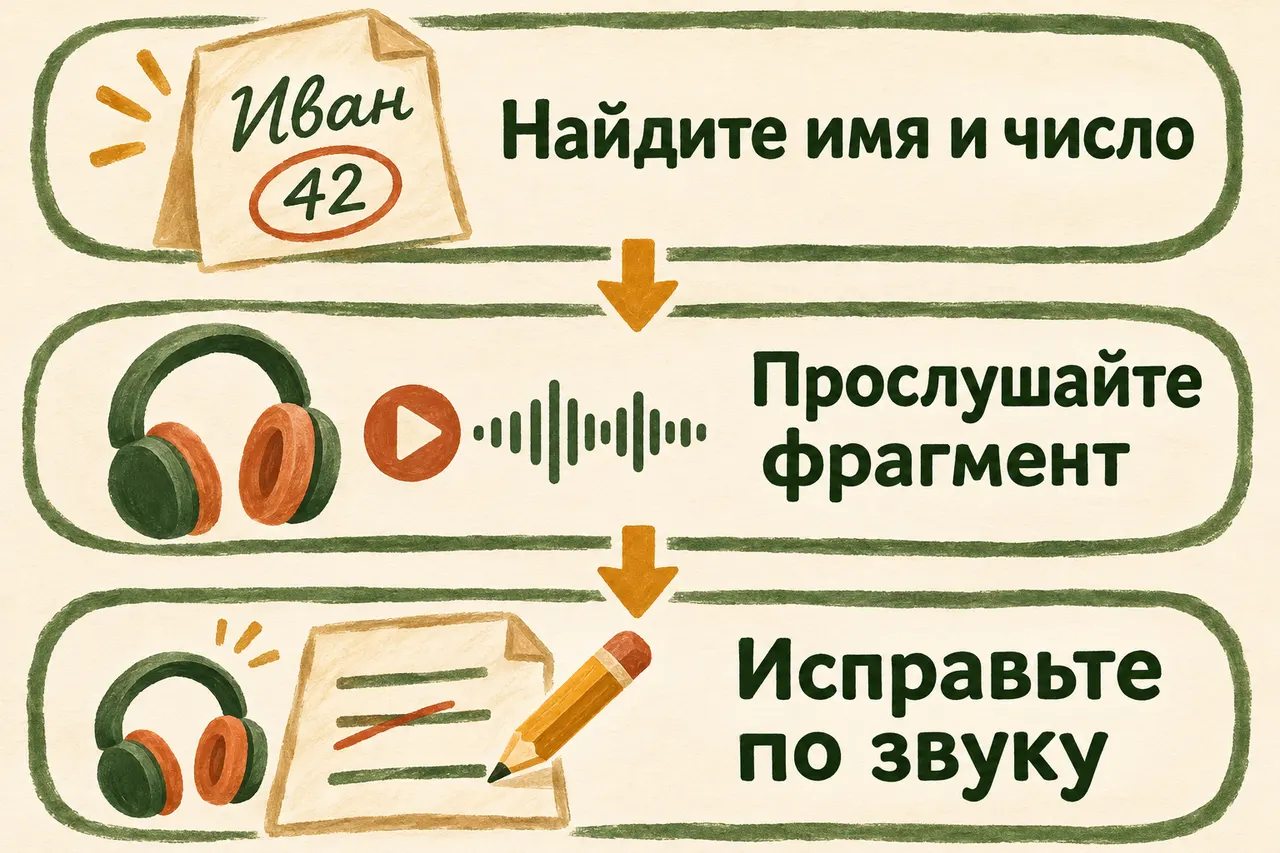
Проверяем содержание короткими участками, а редактуру красивого текста оставляем на потом.
Получился маленький законченный результат: у вас есть короткая расшифровка, её важные сведения сверены с записью, а непонятное место видно сразу. Распознавание речи уже помогло пройти большую часть пути; оставшаяся работа понятна и ограничена.
Попросите ИИ найти места, которые стоит переслушать
Текстовый помощник полезен как внимательный читатель. В доступном DeepSeek можно показать обезличенный фрагмент и попросить составить список вопросов к нему. Аудио для этой роли ему не требуется: он ищет неясности в данном тексте.
Помоги проверить расшифровку моей короткой заметки.
Вот текст: [вставьте фрагмент без личных сведений].
Найди имена, даты, количества и места, где смысл неясен.
Не заменяй их по догадке и не дописывай новые события.
Дай короткий список: что именно мне переслушать.
Если не хватает контекста, задай один вопрос.
Я сверю запись и сообщу, какие слова там слышны.
После этого помоги поправить текст, сохранив смысл.
Первый полезный ответ — список вроде «проверьте имя в начале, день встречи и слово после него». Если вместо списка помощник сразу написал красивый рассказ, попросите вернуться к исходному фрагменту и указать конкретные места.
После прослушивания сообщите подтверждённую поправку: «В записи слышно “пятнадцатого”, оставь 15 июня». Теперь у помощника появился материал для исправления. Если слово всё ещё не разобрать, так и напишите: «Имя пока оставь под вопросом». Чат поможет оформить заметку, а пустое место дождётся настоящего ответа. Такой разговор удобнее просьбы заново угадать всё целиком.
Для длинной записи можно двигаться по одному эпизоду. Обсудили начало, сверили спорное слово, получили чистый абзац — перешли дальше. В собственном рассказе о поездке это заодно помогает отделить две похожие фамилии или два места, которые вы упомянули почти подряд. В итоге поиском находится нужный эпизод, и слушать всё путешествие ради одной остановки уже не приходится.
Почему ошибка иногда выглядит как целое предложение
У ошибки распознавания речи может оказаться разный размер: неверное имя заметить легче, чем гладкое добавление. В полной карточке Whisper разработчики отдельно описывают возможность появления текста, которого в аудио не было. Там же отмечена неодинаковая точность для разных языков, акцентов и диалектов. Это важные свойства конкретного семейства моделей, а не измерение вашего приложения.
Подозрительно завершённую мысль тоже сверяют со звуком. Допустим, на записи человек начал «А потом мы…», отвлёкся и замолчал. Если в тексте после этого возник подробный финал прогулки, переслушайте этот участок. Рассказчик ещё ищет ключи в кармане, а текст уже отвёл всю семью на набережную и вернул домой к ужину. Для настоящего воспоминания нам понадобятся его слова.
Непонятный участок удобнее сохранять вместе с ближайшими словами. Пометка «после “у моста” — неразборчиво» поможет вернуться в нужное место даже без точных временных меток. Если приложение показывает время фрагмента, запишите и его. Сам по себе уверенный тон предложения место в записи не заменяет.
Речь в текст, текст в голос и другие задачи
Распознавание речи отвечает на вопрос «какие слова прозвучали?». Синтез решает обратную задачу: по написанному тексту создаёт звучащую речь. В голосовом помощнике оба действия могут стоять в одной цепочке: услышать вопрос, подготовить ответ, произнести его.
Отдельно могут работать разделение реплик по говорящим и определение личности по голосу. Ещё дальше находится попытка судить о чувствах или чертах человека. Наличие аккуратной расшифровки само по себе таких выводов не даёт. Для нашей заметки достаточно сохранить слова; внутренний мир Нины можно обсудить с Ниной.
Поэтому название приложения иногда скрывает несколько разных операций. Оно может сначала выполнить распознавание речи, потом убрать повторы, затем составить краткий пересказ. Если вы проверяете, что было сказано, открывайте исходную расшифровку и запись. Если хотите получить удобные пункты для себя, после сверки можно попросить отдельное резюме.
Частые вопросы
Если два сервиса написали одинаково, это подтверждение?
Это повод проверить интересующее место, особенно имя или число. Две системы могли выбрать одну привычную формулировку. Окончательная опора для сказанного — запись и, когда звук неясен, уточнение у говорящего.
Можно сразу убрать все оговорки?
Для личной заметки можно попросить читаемую редакцию после проверки смысла. Полезно оставить исходный текст рядом. Тогда случайно пропавшее «не» или поменявшееся действие можно восстановить без повторной расшифровки всего файла.
Зачем хранить аудио, если текст уже готов?
По тексту удобно искать, по звуку — проверять. Назовите их похоже и держите рядом, чтобы найденная строка приводила к нужному рассказу. Способ хранения выбирайте привычный: папка с файлами, заметка со ссылкой, приложение с прикреплённым аудио.
Нужно понимать устройство модели, чтобы пользоваться расшифровкой?
Для работы с распознаванием речи достаточно помнить путь «звук — обработка — вариант текста» и проверять важные места. Термины помогут читать описание сервиса, а первый полезный результат получается и без знакомства со спектрограммами.
Верните заметке её адресата
Когда имя и день сверены, текстом приятно пользоваться: перенести встречу в календарь, найти нужный эпизод рассказа, собрать подписи к семейному видео. В этом и есть выигрыш от распознавания речи — устный материал становится доступнее для дальнейшей работы.
В «Первопроходцах» можно продолжить с собственными записями, текстами и замыслами: осваивать ИИ, задавать вопросы и дорабатывать проектные работы с личной проверкой Никиты Малова. Условия участия в клубе — здесь.
А первую заметку уже можно сохранить. У встречи снова правильный день и своя Нина. Заботливой обезьяне можно выдать миску фруктов. Расписание на июнь подержим у себя.