Коза Мона из «Скотного двора» подбирает газетные обрывки и читает их остальным животным. Клочок бумаги найден, буквы разобраны, новость оглашена. Три разных действия обходятся без трёх новых комитетов — на ферме их и без того хватает. Но спросишь, откуда взялась определённая новость, — и придётся снова распрямлять ту самую газету.
Собираетесь вечером в музей фонарей. Камера уже в сумке, а у вас три простых вопроса: до скольких открыто, где вход и можно ли снимать. На странице поиска появляется короткий ответ со всеми тремя деталями. Удобно — можно собираться. Только сведения пришли из разных мест, и сейчас мы проследим, как они встретились в одной строке.
Положим перед собой два коротких авторских документа. Их хватает, чтобы пройти от найденной страницы к составленному ответу. Мы будем видеть весь материал и сможем показать, откуда пришла каждая деталь.
Поисковая система и искусственный интеллект на одной схеме
Первый документ назовём А — «Расписание музея фонарей»:
В субботу музей открыт до 21:00. Вход со двора.
Второй, Б, — «Памятка гостю музея фонарей»:
Фотосъёмка без вспышки разрешена.
Вопрос: «Можно ли прийти в субботу вечером с камерой и где находится вход?» В А есть сведения о времени и входе. В Б — условие съёмки. Каждый документ отвечает на свою часть вопроса; вместе они дают больше.
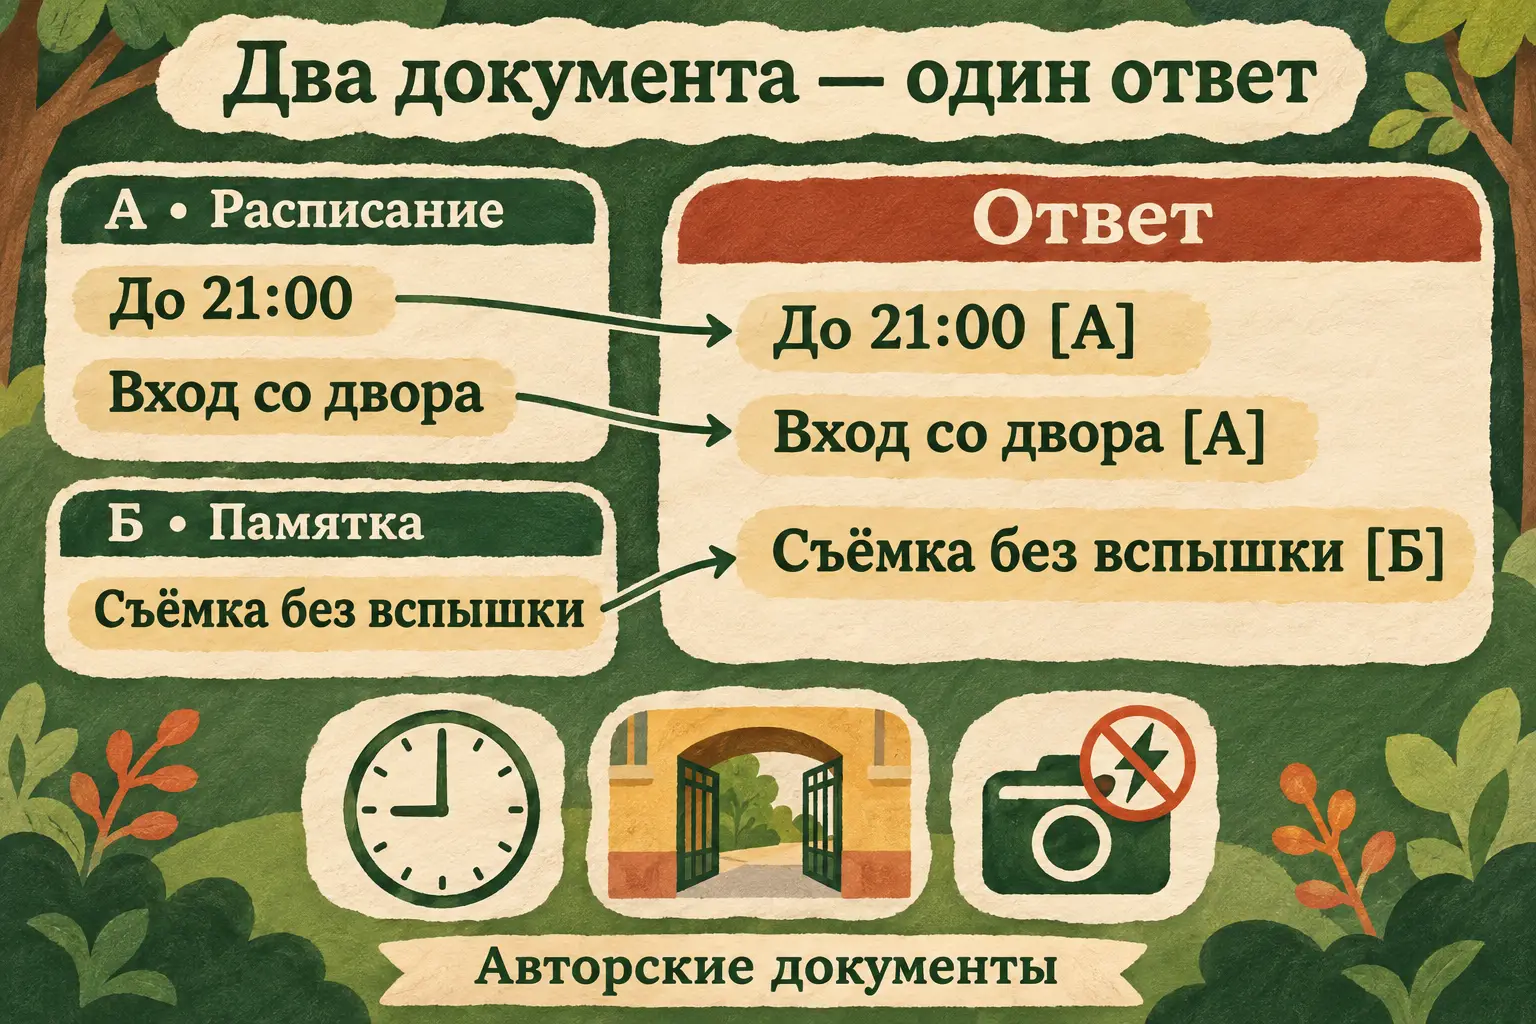
Два документа и их вклад в ответ. Это авторский пример, а не результаты настоящей выдачи.
Запишите на отдельных карточках три варианта результата. На первой — название и ссылка на А. На второй рядом с ними — короткий фрагмент А. На третьей — новая фраза по обоим документам: «В субботу можно прийти до 21:00, вход со двора; фотографировать разрешено без вспышки». Карточки можно положить рядом: на них выполнены разные действия.
Для последней фразы понадобились обе записи. Слова связаны заново, но сведения о времени, входе и съёмке имеют свои адреса. На этом маленьком столе уже видно, что найти документ и сформулировать ответ — разные части работы.
Страницу сначала нужно обнаружить
Когда вы задаёте вопрос, поисковику нужен набор материалов, в котором можно искать. В веб-поиске сведения о страницах собирают заранее. Автоматические программы обходят известные адреса и обнаруживают новые, в том числе по ссылкам с уже найденных страниц.
Следующий шаг — обработать содержимое и сохранить сведения в индексе. Индекс помогает искать по собранным материалам. Он не равен всему интернету: не каждая известная страница доступна для обхода и не каждая обработанная страница оказывается в индексе.
Google разделяет обход, индексирование и выдачу результатов. Эти стадии удобны и для нашей схемы: сначала программа смогла узнать о документе А, затем обработала его, а после пользовательского вопроса выбрала материал для показа.
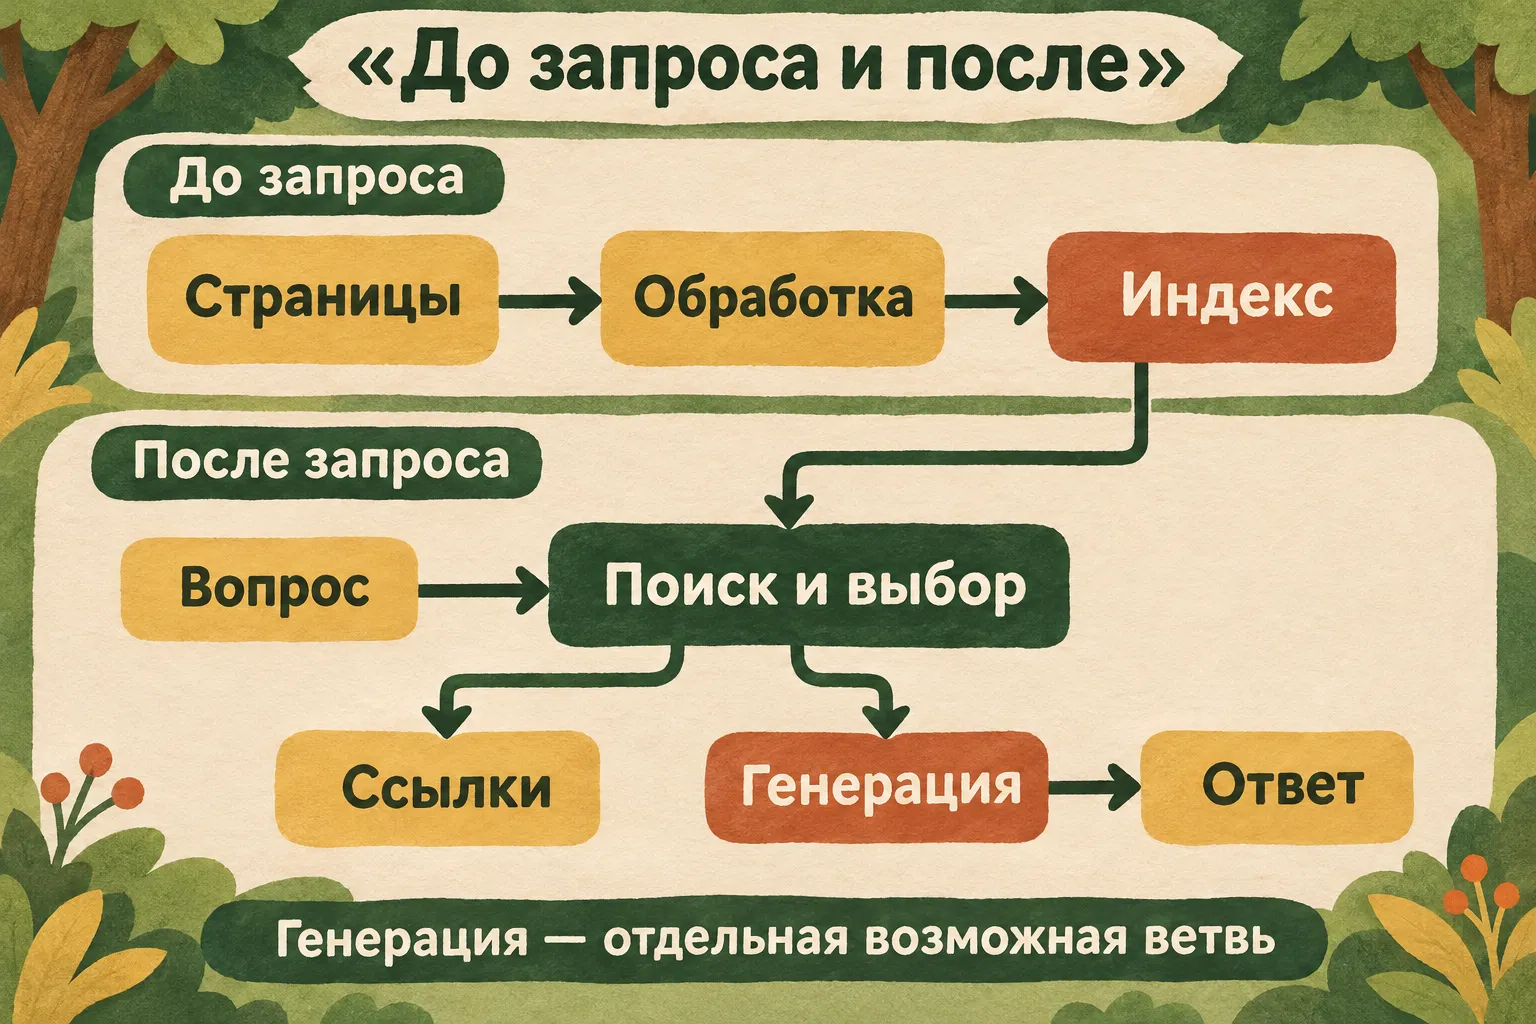
Схема разделяет подготовку набора страниц и действия после вопроса. Генерация показана отдельной возможной ветвью.
У нашего музея есть памятка Б, однако в используемый набор материалов она могла не попасть. Тогда взять из неё условие о вспышке не получится. В момент вашего вопроса весь интернет не выстраивается перед поисковиком в очередь с раскрытыми страницами: работа начинается с доступного ему материала. Для своего вопроса откройте сайт музея и найдите памятку сами. Добытая строка даст ответ про вспышку; заодно станет понятно, какого материала не хватало в прежней подборке.
Музей мог уже изменить часы работы на сайте, пока в использованной подборке осталось прежнее условие. Между изменением страницы и её новым представлением в поиске есть обработка материалов. Перед сегодняшней поездкой откройте расписание и сверьте день. На вашей карточке нужно уточнить одну конкретную строку: до скольких пускают в эту субботу.
Нашли несколько страниц — нужно выбрать и упорядочить
После запроса система подбирает подходящие материалы и решает, что показать раньше. Это ранжирование — упорядочивание результатов по используемым сигналам. Вопрос о входе и вопрос о правилах фотосъёмки могут требовать разных страниц одного сайта.
Передвиньте карточки на столе. Спросили «где вход?» — кладём А ближе. Спросили «можно ли фотографировать?» — придвигаем Б. Для общего вопроса оставляем оба. Это ручной разбор подходящего материала; реальная система работает на гораздо большем наборе и учитывает множество признаков.
Поиск может сопоставлять запрос с материалом по смыслу, даже если слова не совпали буквально. Например, мы написали «с камерой», а в Б указана «фотосъёмка». Для понимания связи не обязательно встретить одну и ту же последовательность букв. В официальном описании систем ранжирования Google названы нейронное сопоставление и RankBrain, которые помогают связывать запросы, понятия и страницы.
Уже на этапе сопоставления вопроса и страницы может работать ИИ. Вопрос «с камерой?» связан с «фотосъёмкой» по действию, которое вы собираетесь выполнить. А составление связной сводки — ещё одна возможная функция того же поискового продукта.
Вот А оказался первым. Теперь у вас есть удобный переход к расписанию, но строку о времени всё ещё нужно прочитать. Выбор страницы решил, куда смотреть; её содержание сообщает, что там написано. Это различие пригодится, когда рядом окажутся общий раздел музея и отдельное расписание вечернего посещения.
Ссылка, фрагмент и составленный ответ
Оставим рядом три карточки, чтобы различие было видно без технических названий.
| Вид результата | Что видит читатель в нашем примере | Куда вернуться за основанием |
|---|---|---|
| Ссылка | «Расписание музея фонарей», документ А | Открыть А |
| Фрагмент | «В субботу музей открыт до 21:00» | Прочитать эту строку и соседний текст в А |
| Составленный ответ | Время и вход из А, съёмка без вспышки из Б | Открыть оба документа и сверить каждую часть |
На первой карточке остаётся адрес: по нему можно открыть страницу. На второй уже видна нужная строка А, которую мы выписали дословно. У настоящего поисковика короткое описание может формироваться иначе; здесь мы видим происхождение выбранного фрагмента, потому что положили рядом весь А.
Составленный ответ соединяет сведения и формулирует их заново. В нашем случае появилась одна фраза вместо двух документов. Читателю удобно с ней собраться: прийти до девяти, найти вход со двора, взять камеру и оставить вспышку выключенной.
В справке Google об AI Overviews генеративный обзор описан как сводка с ключевыми сведениями и ссылками для дальнейшего изучения. Такой блок может появиться там, где система сочтёт его полезным. Его наличие и вид зависят от поискового продукта и конкретной выдачи; здесь нам важен отдельный шаг составления текста.
Откройте А по ссылке возле ответа. До 21:00 — нашли. Со двора — тоже нашли. Про вспышку в А ни слова: это условие пришло из Б. Вы уже можете объяснить, почему одна ссылка не закрыла всё предложение. Дочитайте соответствующее место во второй памятке — и у каждой части появится своё основание.
Прикрепим к словам их происхождение
Возьмите карандаш и проведите три линии от составленного ответа к документам. «В субботу до 21:00» — к А. «Вход со двора» — тоже к А. «Съёмка без вспышки разрешена» — к Б. На карточке ответа оказалась одна фраза, но линии показывают два разных основания.
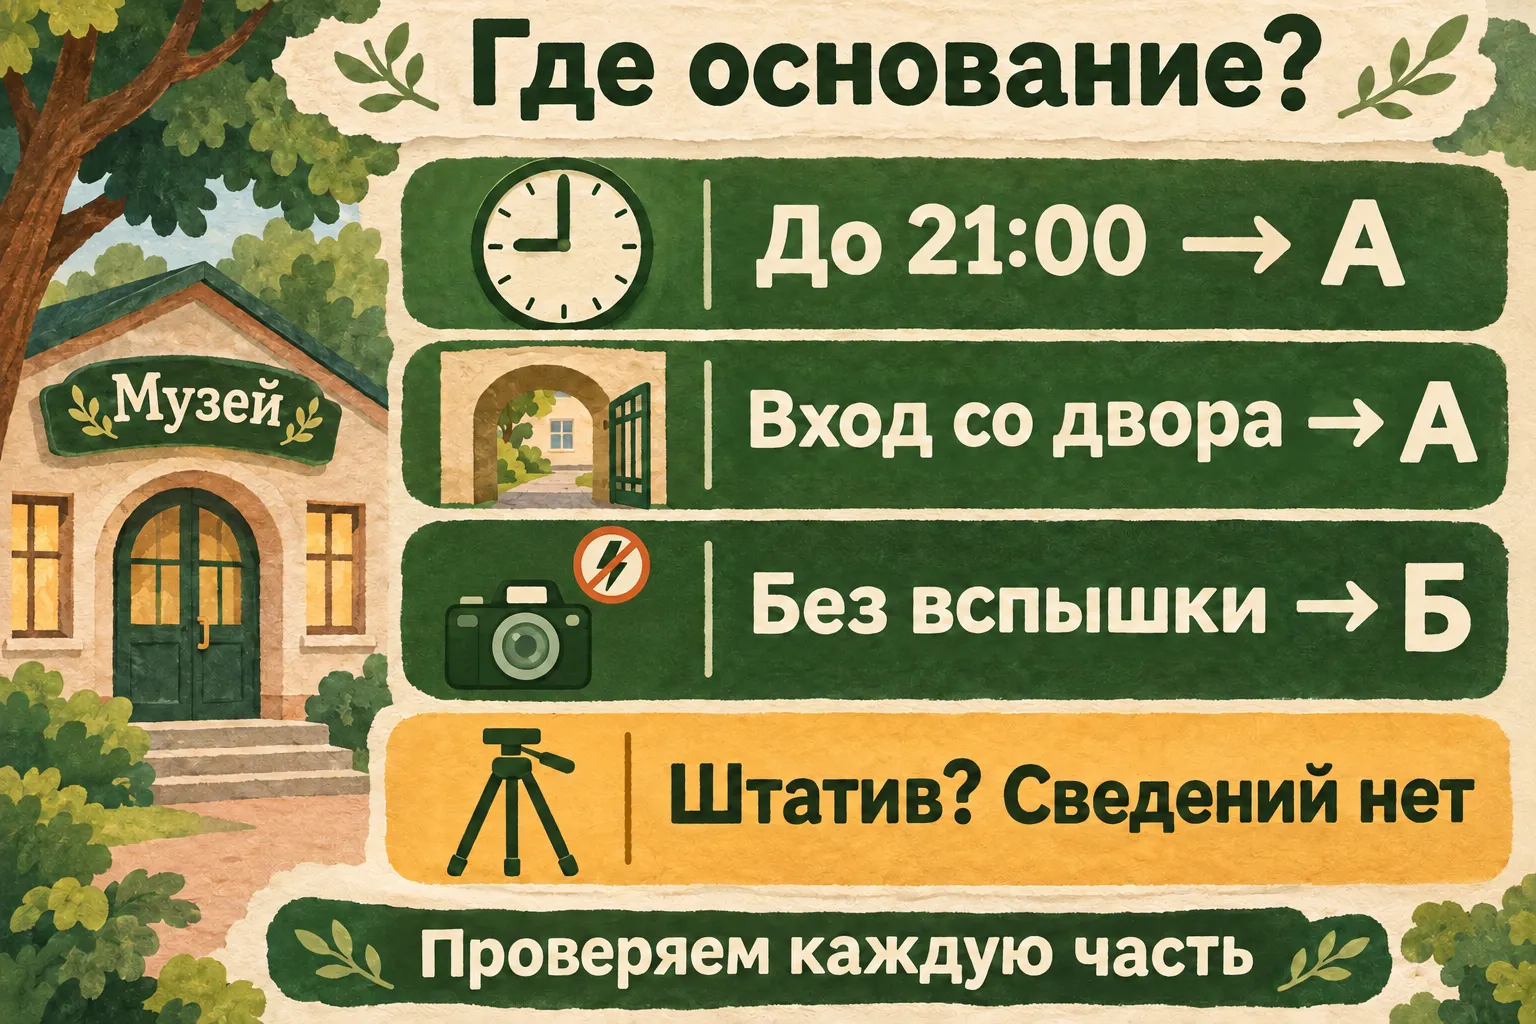
Карта происхождения утверждений. Для штатива в наших двух документах условия нет.
Вы достаёте из шкафа штатив — и возникает новый вопрос: его можно взять? В А есть часы и вход, в Б разрешена съёмка без вспышки. Ни одна из строк пока не говорит о штативе. На карточке поездки возле него остаётся вопрос; ответ нужно найти в дополнительной памятке или уточнить у музея.
Это хорошее место, чтобы вернуть задачу поиску. Запросить правила для штатива, найти соответствующий раздел, открыть его и добавить новое основание. Предыдущие три части ответа при этом уже имеют свои источники; весь разбор начинать с нуля не требуется.
Здесь особенно заметны разные роли. Поиск помогает получить недостающий документ. Выбор материала выделяет нужный раздел. Генерация может включить найденное условие в короткий ответ. Затем вы открываете исходную строку и читаете именно про штатив. У него три ноги, но на приём его всё же записывают по музейной памятке, а не по числу опор.
Представьте, что ответ уже переслали другу, а затем нашли обновлённое расписание. Исправить можно ровно ту часть, которая опиралась на прежний А: время посещения. Про съёмку вы смотрите Б. Вместо нового пересказа всей истории получится короткое понятное уточнение — вместе с адресом изменившегося источника.
Попросите помощника разложить ответ по документам
Первую пробу можно сделать в обычном чате, потому что оба текста уже лежат перед вами. Откройте DeepSeek или привычный текстовый помощник и вставьте документы вместе с вопросом. Его работа — составить короткий ответ и показать происхождение частей.
Помоги понять, как ответ складывается из источников.

Документ А. Расписание музея фонарей:
«В субботу музей открыт до 21:00. Вход со двора».
Документ Б. Памятка гостю того же музея:
«Фотосъёмка без вспышки разрешена».

Вопрос: можно ли прийти в субботу вечером с камерой и где вход?
Составь короткий ответ. После каждой части поставь А или Б
и покажи дословную строку, на которую опираешься.
Затем отдельно ответь, что из этих документов известно про штатив.
Если сведений нет, скажи, какой вопрос нужно выяснить дополнительно.
Сверьте ответ по трём деталям: время и вход должны вести к А, съёмка без вспышки — к Б. У штатива пока останется вопрос. Если помощник уже выдал для него условие, попросите показать эту строку в А или Б. На двух коротких документах достаточно одного возвращения глазами, чтобы увидеть, что в них действительно есть.
В этом упражнении чат получил готовые документы; обход веба и настоящий индекс мы разобрали на схеме. Теперь у вас видны обе стороны ответа: какие строки были даны и какая фраза из них появилась. Большую поисковую страницу можно читать с теми же вопросами к происхождению сведений.
Для собственного вопроса сохраните рядом адрес источника и нужный абзац. Можно попросить ИИ разобрать один сложный переход и подождать вашего ответа: «Вот фраза и документ, покажи, какие слова её поддерживают». Если в чате есть поиск, уточните, какие страницы он действительно открыл. Без поиска вставьте нужный материал сами.
Когда задача уже состоит в поиске настоящей официальной справки, продолжите по инструкции как искать источники с помощью ИИ. А для отдельного спорного утверждения пригодится проверка факта по источнику. Эта карта объясняет путь ответа; инструкции помогают пройти выбранный участок на своём вопросе.
В клубе можно продолжить работу с собственными материалами: поставить вопрос, обсудить ответ и улучшить его. Условия участия в «Первопроходцах» ведут к следующему шагу. Начать такую практику удобно с того, что уже хочется выяснить для себя.
Частые вопросы
Поисковик — это одна нейросеть?
Поисковый продукт включает разные процессы и компоненты. В нём могут работать несколько механизмов ИИ: например, для сопоставления запроса с материалом и для составления обзора.
Если показаны только ссылки, ИИ там отсутствует?
По одному виду выдачи такого вывода не сделать. ИИ может помогать понимать запросы и выбирать страницы без генеративной сводки.
Генерация всегда нужна для поиска?
Ссылки на документы и короткий обзор — разные варианты результата. Можно найти нужную страницу и прочитать её напрямую, а составленный ответ удобен, когда нужно связать сведения.
Как узнать, откуда взялась конкретная фраза?
Разделите её на утверждения и откройте поддерживающие материалы. В нашем примере время и вход подтверждаются А, условие съёмки — Б, а про штатив сведений пока нет.
Камера в сумке, время выписано, вход найден. Три короткие линии от ответа ведут к двум документам, а возле штатива остался отдельный вопрос. Козе Моне пришлось бы снова распрямлять газету. Вы открываете памятку — уже понимая, какую строку ищете. Фонари дождутся вечера; источник найден сейчас.