На ферме Оруэлла Стукач зачитывает цифры о прекрасной жизни, а животные тем временем голодны. На ферме уже есть и знамя, и торжественная речь, и залп из пушки. У животного, которому хочется поесть, с этим набором остаются некоторые затруднения. Сцена неприятная, зато помогает задать точный вопрос к любой оценке: что именно она считает?
В задачах ИИ тоже полезно увидеть устройство оценки. Слово «награда» звучит по-человечески: будто программу похвалили, она довольно загудела и получила сухарик через разъём. В нашем разборе это будет обычное число, которое выдаётся по заранее заданному правилу игры.
Возьмите лист бумаги и фишку — подойдёт пуговица. Мы устроим учебную игру, где можно получить небольшую награду прямо сейчас или сделать несколько шагов к большей. Поставим рядом два результата: что досталось фишке за один выбор и что она собрала к концу попытки. Разница между ними объяснит дальнейшие названия.
Обучение с подкреплением начинается с действия и ответа среды
Нарисуйте в ряд четыре кружка. Первый подпишите Старт, два следующих — 1 и 2, последний — Финиш. Поставьте фишку на старт. У одной попытки будет ровно три хода.
На каждом ходу доступны два действия:
- Вперёд — передвинуть фишку на соседний кружок справа. За приход на клетки 1 и 2 награда равна нулю; за приход на финиш — пять очков.
- Жетон — получить одно очко и остаться на месте.
Оба действия тратят один ход. После третьего хода попытка заканчивается. Все очки в этой игре просто складываются; дополнительных бонусов за красивую историю или скорость передвижения нет.
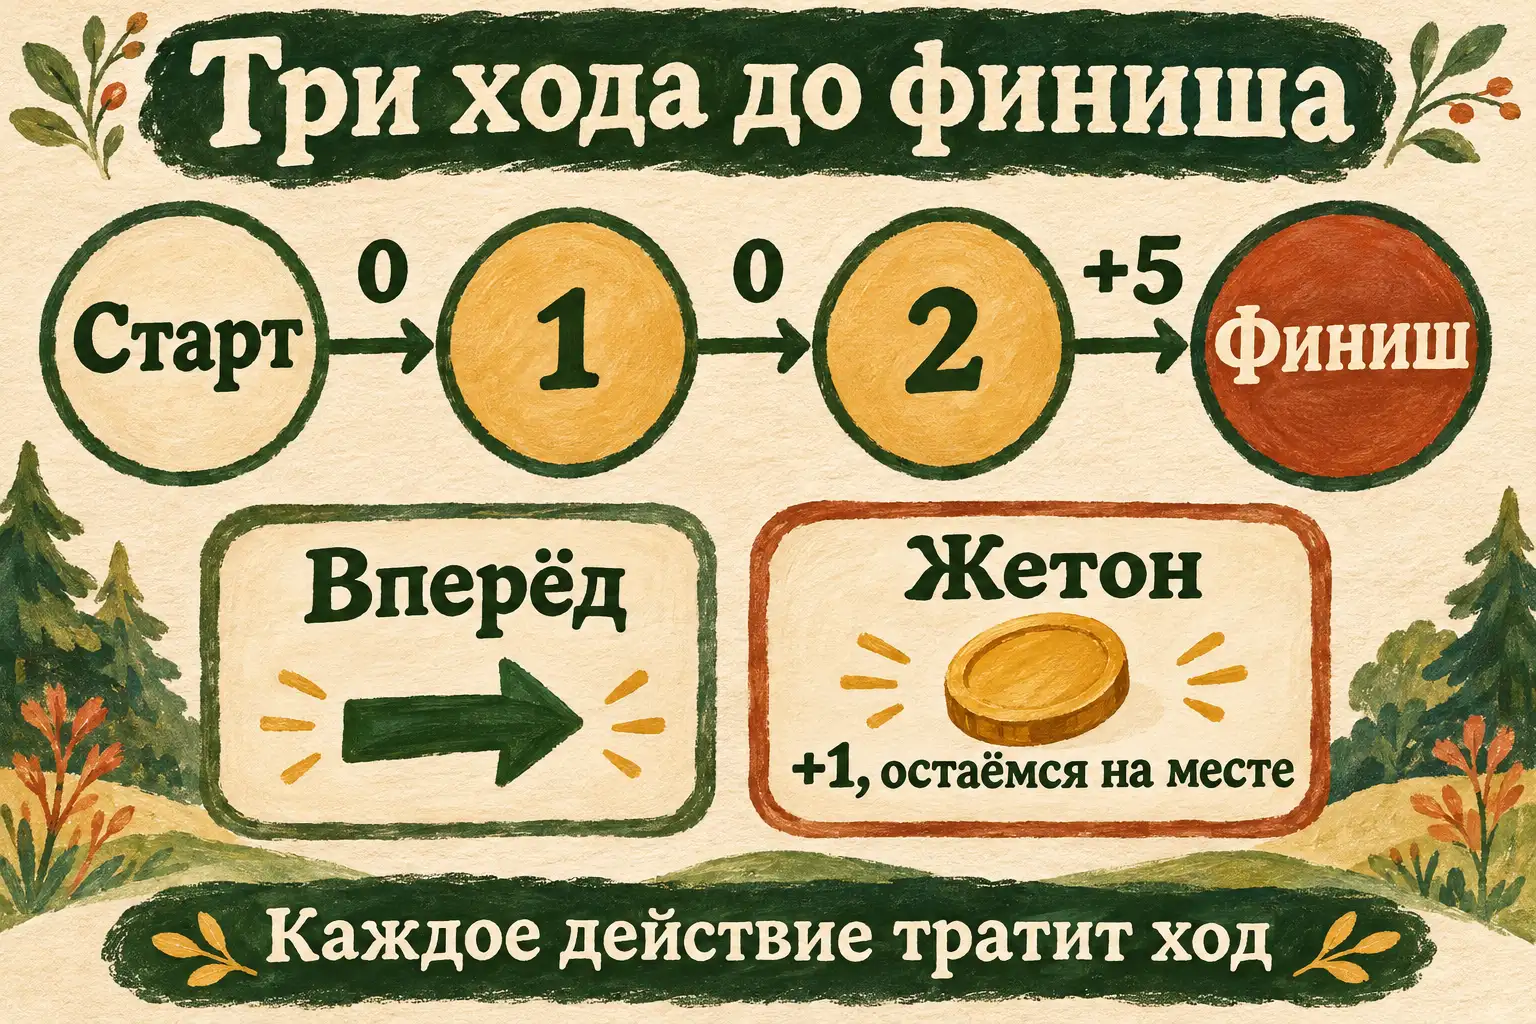
Одна и та же попытка ограничена тремя действиями. Взять жетон и передвинуться одновременно нельзя.
Теперь сделайте один ход Вперёд. Фишка окажется на клетке 1, ходов останется два, награда за этот шаг — ноль. Уже виден маленький цикл: было положение, выбрали действие, получили новое положение и числовой результат.
Во вводном уроке Google о машинном обучении этот подход связывают с действиями в среде и выработкой стратегии по наградам. В нашей игре всё лежит на столе, поэтому устройство цикла можно проверить руками.
Кто играет, где играет и что сейчас видит
Агент — тот, кто выбирает действие. Пока эту роль выполняете вы. В программной задаче действия выбирает обучаемая система. Пуговица изображает положение игрока; сама она ничего не решает.
Среда — игровое поле вместе с правилами переходов и выдачи очков. Вы выбрали «Вперёд», среда перевела фишку на следующую клетку и сообщила награду. В компьютерной игре эту работу выполняет программа, на бумаге правила исполняет человек.
Состояние описывает текущую ситуацию, важную для выбора. Нам нужны и положение фишки, и оставшиеся ходы. «Старт, три хода впереди» отличается от «Старт, один ход остался»: до финиша три перехода, а времени на них теперь не хватает.
Действия — два доступных выбора: двигаться или брать жетон. Награда — число, полученное после конкретного действия. Эти названия не требуют нейросетевого оборудования: их можно найти в нашей простой записи.
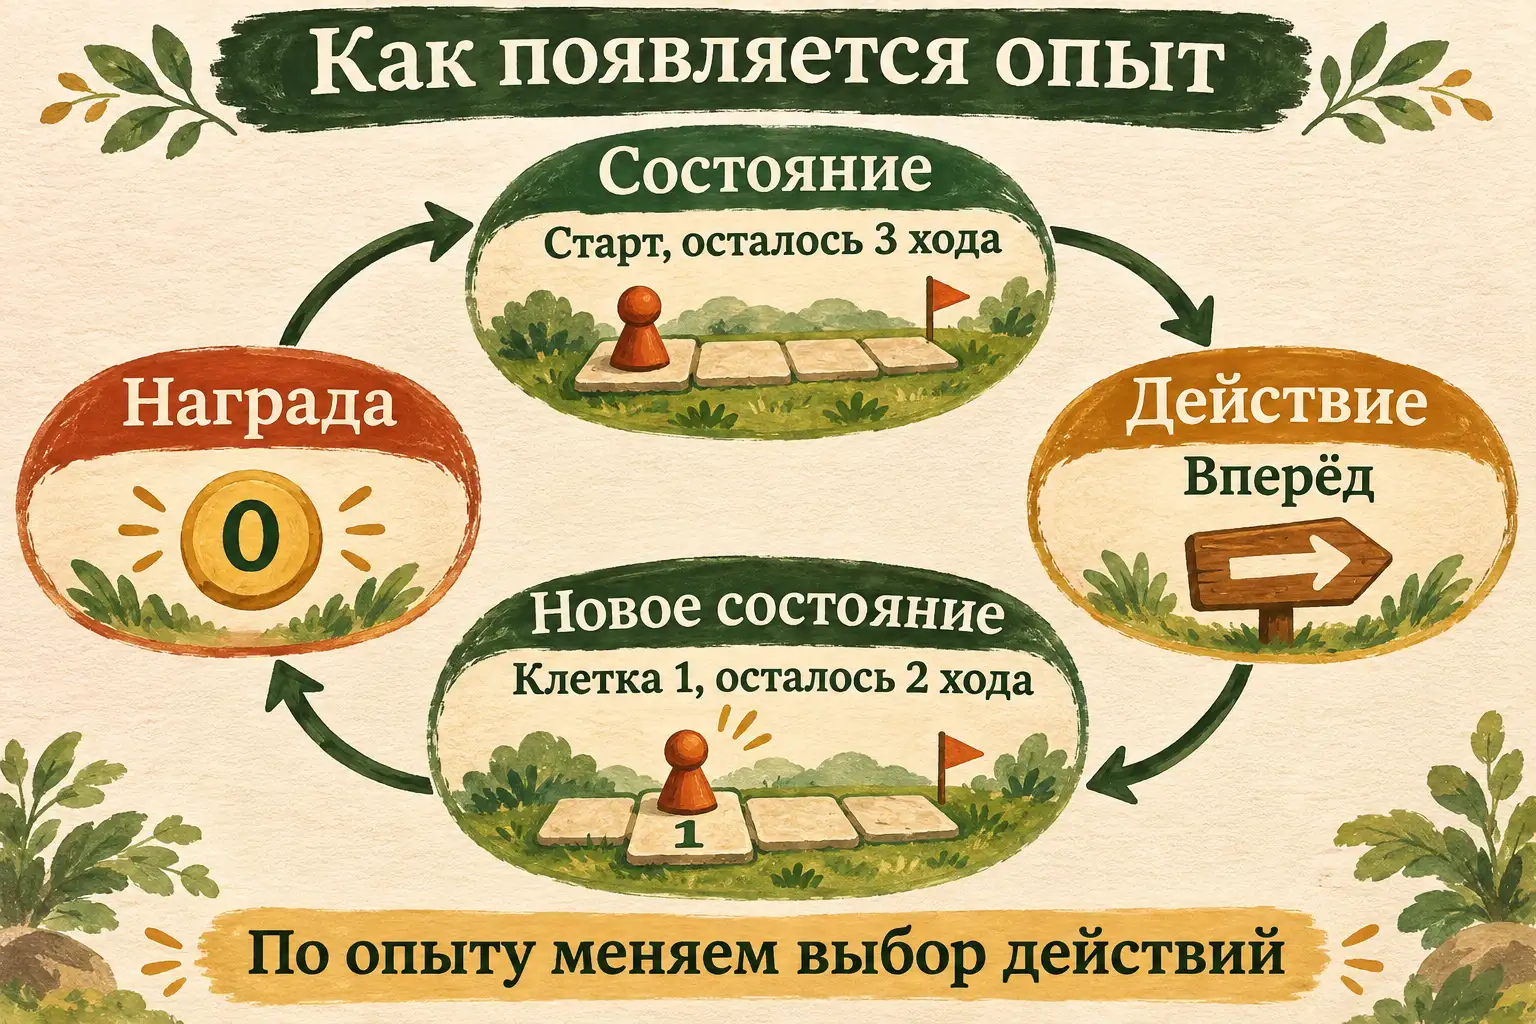
Схема одного перехода. Агент получает опыт и может менять последующий выбор действий.
Для записи опыта достаточно строки: «Был на старте с тремя ходами → выбрал Вперёд → оказался на клетке 1 с двумя ходами → получил 0». На следующем шаге исходная ситуация уже другая. Именно последствия предыдущего действия создают условия для нового.
Это объясняет, почему вопрос «Какой ход лучший?» требует продолжения: в каком состоянии и с какой целью? Когда остался один ход и фишка стоит на старте, движение принесёт ноль, жетон — одно очко. Когда фишка на клетке 2, тот же последний шаг вперёд даст пять.
Получить сейчас или дойти потом
Верните фишку на старт и восстановите три хода. Сначала трижды выберите Жетон. Каждый раз вы получаете одно очко. В конце у вас три очка, а фишка всё ещё на старте.
Теперь начните новую попытку и трижды выберите Вперёд. На первом шаге — ноль. На втором — тоже ноль. Только на третьем придёт награда за финиш: пять очков. По сумме эта серия лучше предыдущей.
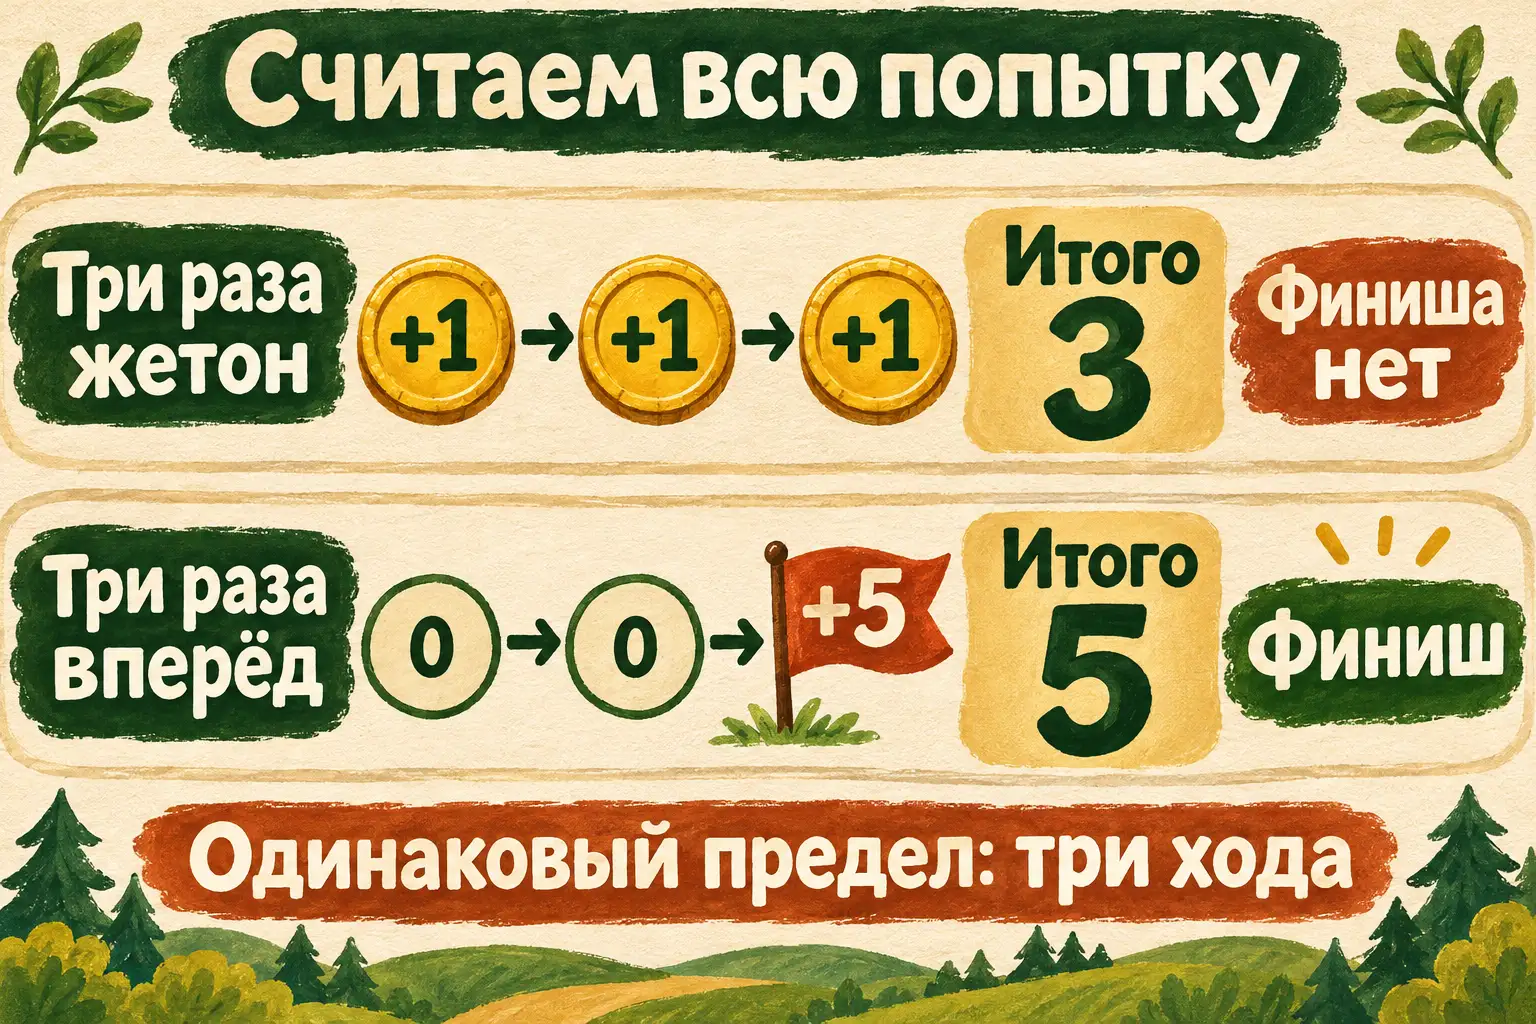
Сравниваем одинаковый предел ходов. Нулевая награда в начале может вести к большему итогу.
Если выбирать только то, что немедленно приносит больше, рука каждый раз потянется к жетону. Счёт бодро растёт после каждого действия. Только фишка так и стоит у старта. До флажка её не приблизил ни один из трёх маленьких успехов.
Добавим смешанный маршрут: сначала Жетон, затем два раза Вперёд. Получено одно очко, фишка дошла лишь до клетки 2. Для финиша недостаёт хода. Это показывает, почему важны и последовательность, и её предел: после остановки уже нельзя добрать недостающий шаг.
| Последовательность | Награды по ходам | Сумма | Положение в конце |
|---|---|---|---|
| Жетон → Жетон → Жетон | 1, 1, 1 | 3 | Старт |
| Вперёд → Вперёд → Вперёд | 0, 0, 5 | 5 | Финиш |
| Жетон → Вперёд → Вперёд | 1, 0, 0 | 1 | Клетка 2 |
В этой маленькой игре результаты можно перебрать полностью. Я просчитал все последовательности из двух действий за три хода: максимальная сумма по исходным правилам — пять, её даёт путь к финишу. Это арифметический разбор поля, который помогает увидеть принцип.
В реальных задачах будущие результаты часто ещё неизвестны, переходы могут зависеть от случайности, а состояний гораздо больше. Поэтому системе приходится получать опыт, оценивать последствия и постепенно улучшать выбор. Наша открытая схема даёт возможность понять, ради чего это нужно.
Где появляется обучение стратегии
Если мы сразу выписали все правила и сами выбрали три шага вперёд, то решили маленькую задачу. Чтобы увидеть идею обучения, представьте игрока, которому не выдали готовую лучшую последовательность. Он пробует действия и получает от среды состояния и награды.
Сначала он может предпочитать жетон, потому что тот сразу приносит очко. Но если попробовать цепочку движений, обнаружится финишная награда. Теперь нулевой первый шаг можно увидеть в составе удачного пути. Он не выдал очков сразу, зато создал положение, из которого удалось прийти к финишной награде. Алгоритм использует такой опыт, чтобы менять оценки и последующий выбор.
Стратегия, или policy, задаёт, как выбирать действие в текущем состоянии. Она может назначать действиям разные вероятности. Например, пробовать движение, даже когда уже известен небольшой выигрыш от жетона. В словаре Google стратегия связана именно с выбором действий по состоянию.
Здесь возникает понятная задача: использовать то, что уже приносило очки, или исследовать другой вариант. Если всё время брать знакомый жетон, финиш может так и остаться неиспробованным. Если вечно пробовать случайные действия, найденный удачный путь не станет устойчивым выбором.
Конкретные алгоритмы по-разному обновляют оценки и выбирают новые попытки. Наш практикум раскрывает общий механизм, без настройки алгоритма и запуска обученной модели. Вы можете изобразить опыт на бумаге и объяснить, какую информацию он добавляет к следующему решению.
Что изменится, если переоценить жетон
Теперь поменяйте одно правило: за действие Жетон выдаётся два очка. Всё остальное оставьте прежним: те же три хода, пять за финиш, ноль за промежуточное движение.
Три жетона теперь дают шесть очков. Три шага вперёд по-прежнему дают пять. Лучшая по сумме стратегия сменилась: выгоднее оставаться на месте. Вы нарисовали флажок и мысленно приготовились встречать победителя, а выгоднее стало остаться у старта. У фишки теперь доходное местечко прямо на старте. Зачем ей флажок? Можно три хода стоять, собирать очки и предъявить лучший итог.
Если нам нужен именно приход на финиш, стоит согласовать с этим правилом награды. Например, вернуться к исходному одному очку за жетон и снова сравнить варианты. Поле и названия действий не изменились, а основание выбора стало другим.
В этом примере награда — условное число. Оно не измеряет истинность рассказа, доброту игрока или заслуженность человеческой похвалы. Шесть очков означают шесть очков по нашим правилам. Чтобы понять результат, нужно знать, за что именно их выдали.
Здесь и отзывается Оруэлл: длинный список красивых чисел ещё надо соотнести с тем, что вы хотели получить. В игре проверка умещается на одном листе: пальцем показываете финиш, затем положение фишки, затем записанную сумму. Сразу видно, совпало ли то, чего вы ждали, с тем, за что выдавали очки.
Разберите игру вместе с DeepSeek
Попробуйте объяснить правила помощнику и попросить его вести вас по одному ходу. Это хороший способ обнаружить пропуск в собственном описании. Например, вы забыли сказать, что жетон тоже тратит ход, и получили совсем другую игру.
Помоги мне разобраться с бумажной игрой. Есть Старт, клетки 1 и 2 и Финиш. В попытке ровно три хода. Действие Вперёд перемещает на одну клетку вправо: награда 0 за приход на 1 или 2, 5 за приход на Финиш. Действие Жетон даёт 1 очко и оставляет фишку на месте. Каждое действие тратит ход. После третьего попытка кончается, награды складываем. Сначала проверь, все ли правила понятны; если чего-то не хватает, задай вопрос. Затем предложи один ход, дождись моего ответа и помоги записать новое состояние и награду. После попытки сравни её с тремя шагами Вперёд. Не называй нашу переписку обучением нейросети.
Начать можно в DeepSeek обычным сообщением. После первого шага ответьте своими данными: «Я выбрал Жетон, остался на старте, осталось два хода, получил одно очко». Если помощник приписал фишке движение, верните его к правилу: положение не меняется.
Затем попросите изменить только награду за жетон на два. Сравните новую сумму с пятью за финиш. Ваша проверка получится самостоятельной: вы знаете правила, можете пересчитать числа и объяснить, почему поменялся лучший выбор.
Общий способ обсуждать своё дело с помощником есть в статье о запросе под задачу. Здесь полезный результат — не длинный ответ чата, а ваш собственный разбор одной попытки: состояние, действие, результат, сумма.
Вопросы и ответы
Награда обязательно означает, что человек похвалил ИИ?
Нет. В нашей игре она полностью определяется числовыми правилами. В разных системах способы получения оценки различаются; человеческая похвала сама по себе ещё не описывает, как устроен сигнал и обучение.
Это всегда обучение именно нейросети?
Термин описывает способ учиться через взаимодействие и награду. Нейросеть может быть частью такой системы, но для маленьких сред оценки могут храниться и в таблице. Бумажная игра помогает увидеть цикл без выбора устройства модели.
Чем это отличается от обучения по готовым ответам?
В обучении с учителем используют примеры с известными правильными результатами. В нашей игре игрок выбирает действие, меняет ситуацию и получает награду за последствие. Следующие возможности зависят от того, что он уже сделал.
Модель начинает переучиваться от каждой беседы со мной?
Из этого разбора такого вывода не следует. Чат здесь помогает нам объяснять и проверять правила игры. Мы не запускаем процедуру изменения его параметров. Практикум показывает устройство подхода к обучению, а не режим работы конкретного чат-сервиса.
Почему в состоянии нужно оставшееся число ходов?
Потому что от него зависит достижимость финиша. На старте с тремя ходами путь ещё возможен, с одним — уже нет. Одинаковая клетка при разном запасе ходов означает разные условия решения.
Сначала посмотрите, за что дают очки
Теперь вы можете распознать обучение с подкреплением по связке действий, среды, награды и изменения стратегии. На бумаге видно и другое: результат зависит от того, какую последовательность оценивали и что было записано в правилах.
Продолжить такие разборы на собственных интересах можно в стартовой практике «Первопроходцев». В клубе пробуют понятные задачи с ИИ, обсуждают результаты и задают вопросы по ходу работы. Эфиры идут раз в две недели, для отдельного проекта можно выбрать личную проверку Никиты Малова. Условия — на странице клуба.
Петушку из Оруэлла у нас было бы тесно: всё поле на одном листе, а результат можно пересчитать пальцами. Посмотрите, дошла ли фишка до финиша, а потом прочитайте правила: иногда шесть очков честно выдают за то, чтобы никуда не ходить.