Нитобэ пересказывает шутку о трёх японских вождях и соловье, который не поёт вовремя. Один грозит, другой собирается заставить, третий готов подождать. Соловей ещё не раскрыл клюв, а вокруг него уже заседает маленький штаб. Птице осталось запросить протокол.
У фотокружка тоже три коротких распоряжения. Встретиться во вторник. Принимать JPEG. Сдать отчёт в пятницу. Кто-то спрашивает, в каком формате присылать фотографии, и получает торжественное «во вторник». Можно представить новый формат: файл открывается только по вторникам, в среду изображение уходит на выходной.
Чтобы получить нужную строку, сначала передадим поиску все три записи, а потом вернём найденную с подписью. Тогда можно будет открыть исходник и сразу увидеть, попали мы в вопрос или только в собственный архив.
Начнём с маленькой работающей части будущей системы: загрузим записи и запросим подходящую. Именно такой поиск по собственным материалам используют внутри RAG — подхода, при котором помощник получает внешний контекст для ответа.
Что подготовить для n8n RAG
Нужны уже доступный n8n и подключение к провайдеру, который создаёт embeddings. Так называют числовое представление текста для поиска по близости смысла. Нам потребуется одна выбранная модель и при загрузке, и при поиске.
В качестве конкретного пути используем узел Embeddings OpenAI с уже доступными учётными данными. Выберите в нём доступную вам модель и запомните выбор. Подписка на текстовый чат сама по себе не означает доступ к API; условия и оплата внешнего провайдера действуют отдельно. Если у вас уже подключён другой провайдер embeddings, соответствующий узел можно обсудить с помощником.
Для опыта возьмём только эти три записи:
| ID | Текст документа | О чём он |
|---|---|---|
| D1 | Встреча во вторник | День встречи |
| D2 | Принимать JPEG | Формат изображений |
| D3 | Отчёт каждую пятницу | Срок отчёта |
Сохраните этот набор в заметку. Для вопроса «В каком формате принимать изображения?» здесь подходит D2. Мы заранее знаем ответ и проверим новый инструмент на трёх строках, которые помещаются перед глазами. Это приятнее, чем сразу поручить ему весь фотоархив и потом разыскивать причину странного ответа среди тысяч страниц.
Simple Vector Store хранит данные в оперативной памяти. После перезапуска n8n они исчезают, а при нехватке памяти могут быть очищены. Его Memory Key — общее имя хранилища на экземпляре n8n, доступное другим его пользователям. Поэтому для опыта подходят наши открытые вымышленные записи; собственный ключ отделит их от других опытов, но не сделает закрытой базой. Это прямо описано в документации узла.
Сначала увидеть весь путь
В схеме будут две части. Первая загружает документы, вторая задаёт вопрос уже после окончания загрузки. Пока записка про JPEG ещё стоит в очереди, искать её в памяти рано. Для обеих используется одно и то же имя хранилища и та же модель embeddings.
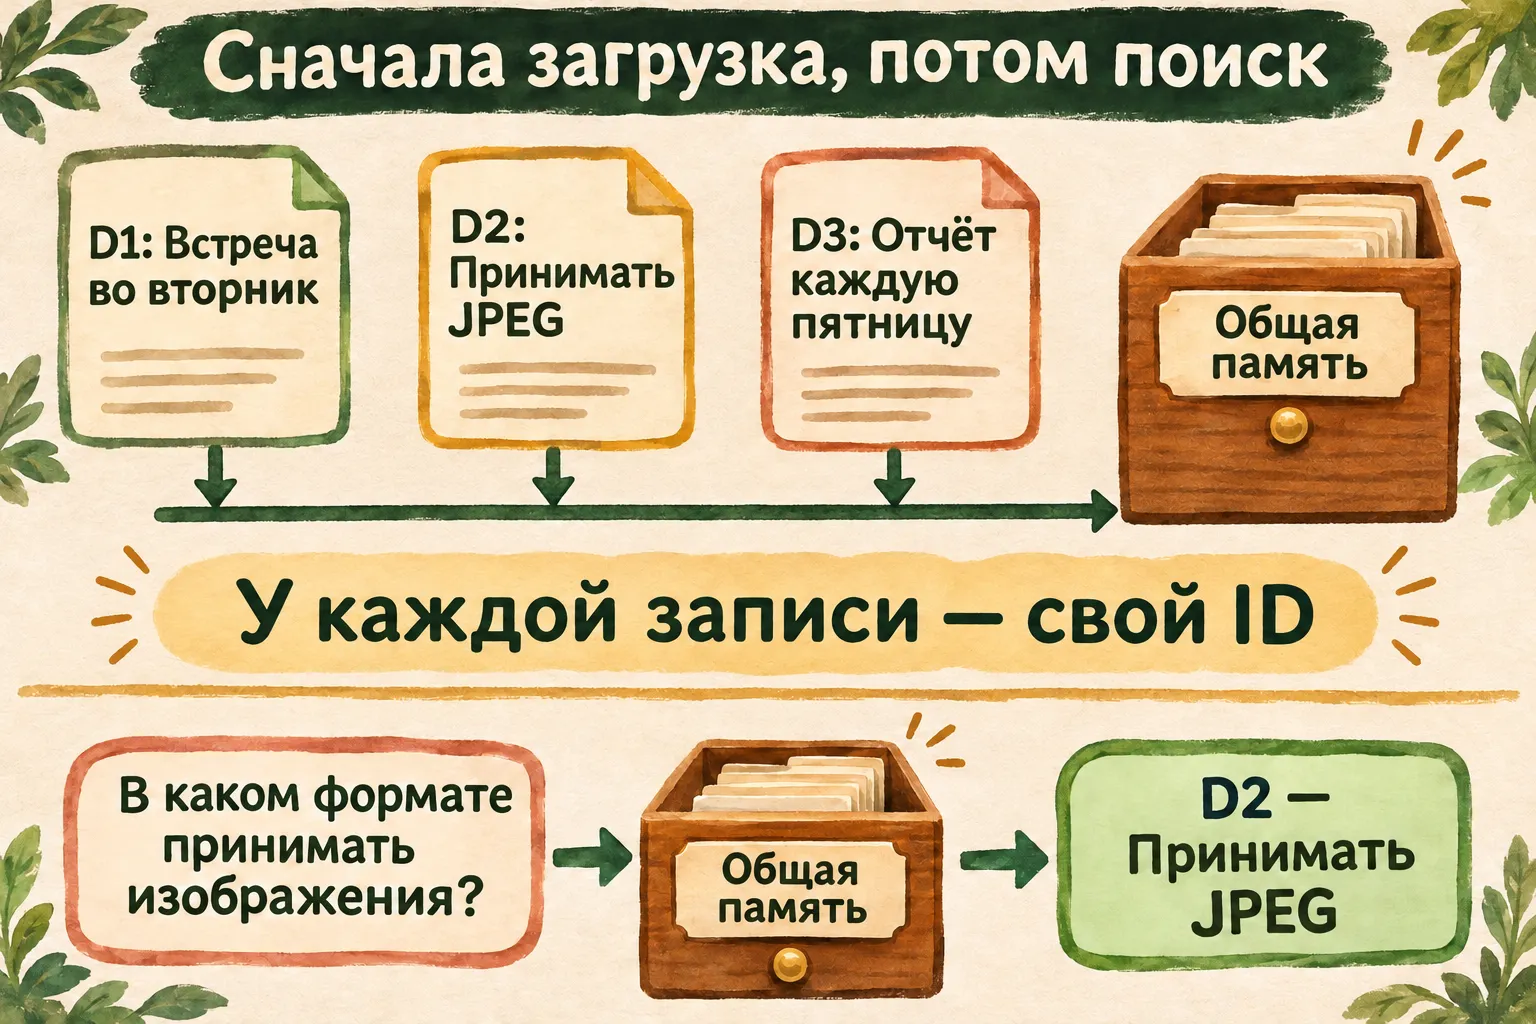 Проверяемый результат первого опыта — найденная запись вместе с её ID.
Перед сборкой откройте DeepSeek и дайте ему задачу. Подойдёт также привычный ChatGPT или Claude, если вы уже ими пользуетесь.
Помоги собрать в моём n8n поиск по трём коротким документам. D1: «Встреча во вторник», D2: «Принимать JPEG», D3: «Отчёт каждую пятницу». Хочу загрузить их по одному в Simple Vector Store и после окончания отдельно выполнить Get Many с вопросом о формате изображения, Limit=1 и метаданными id. Сначала уточни мою версию n8n и доступный узел embeddings. Давай по одному действию: какой узел добавить, какое поле заполнить и что должно появиться на выходе. После каждого шага жди моего ответа. Не проси API-ключ: учётные данные я выбираю внутри n8n. Сохрани порядок загрузки через Loop Over Items с Batch Size=1 и Clear Store выключенным.
С таким запросом у помощника есть и материал, и ближайшая цель: добиться появления нужного текста на выходе. Если интерфейс отличается, пришлите название поля или описание ошибки. Следующий совет должен опираться на то, что у вас действительно получилось. Секреты из Credentials в чат не переносите; для объяснения достаточно названия провайдера и очищенного сообщения об ошибке.
Загрузка: три записи становятся тремя входными элементами
Создайте отдельную схему с Manual Trigger — ручным запуском. После него добавьте Code, выберите JavaScript и режим Run Once for All Items. В поле кода вставьте готовые данные:
return [
  { json: { id: "D1", text: "Встреча во вторник" } },
  { json: { id: "D2", text: "Принимать JPEG" } },
  { json: { id: "D3", text: "Отчёт каждую пятницу" } }
];
Выполните Code. На выходе должны появиться три items — три отдельных элемента с полями id и text. Откройте каждый: D1, D2 и D3 должны присутствовать по одному. На этом шаге уже есть небольшой проверяемый результат: все исходные строки попали в схему и ни одна не потерялась. Режим запуска кода описан в справке Code.
Дальше поставьте Loop Over Items. В Batch Size укажите 1. Его выход loop направьте в Simple Vector Store с операцией Insert Documents. Выход вставки соедините обратно со входом Loop Over Items, чтобы цикл взял следующую запись. Выход done означает, что все записи пройдены; он не должен снова вести в эту вставку.
У загрузки есть одна хитрость, ради которой мы и ставим цикл. В подузлах n8n выражение берёт первый входной item. Если дать загрузчику пачку из трёх, он может взять из неё только первую запись. Вы будете ждать формата изображения, а в памяти окажется день встречи.
Batch Size=1 делает каждую запись первой и единственной на своём проходе. Загрузчик получает D1, затем D2, затем D3. День встречи больше не выступает за весь фотокружок. Для окончания обхода есть отдельный выход done. Эту особенность объясняет Default Data Loader, а выходы loop и done — справка Loop Over Items.
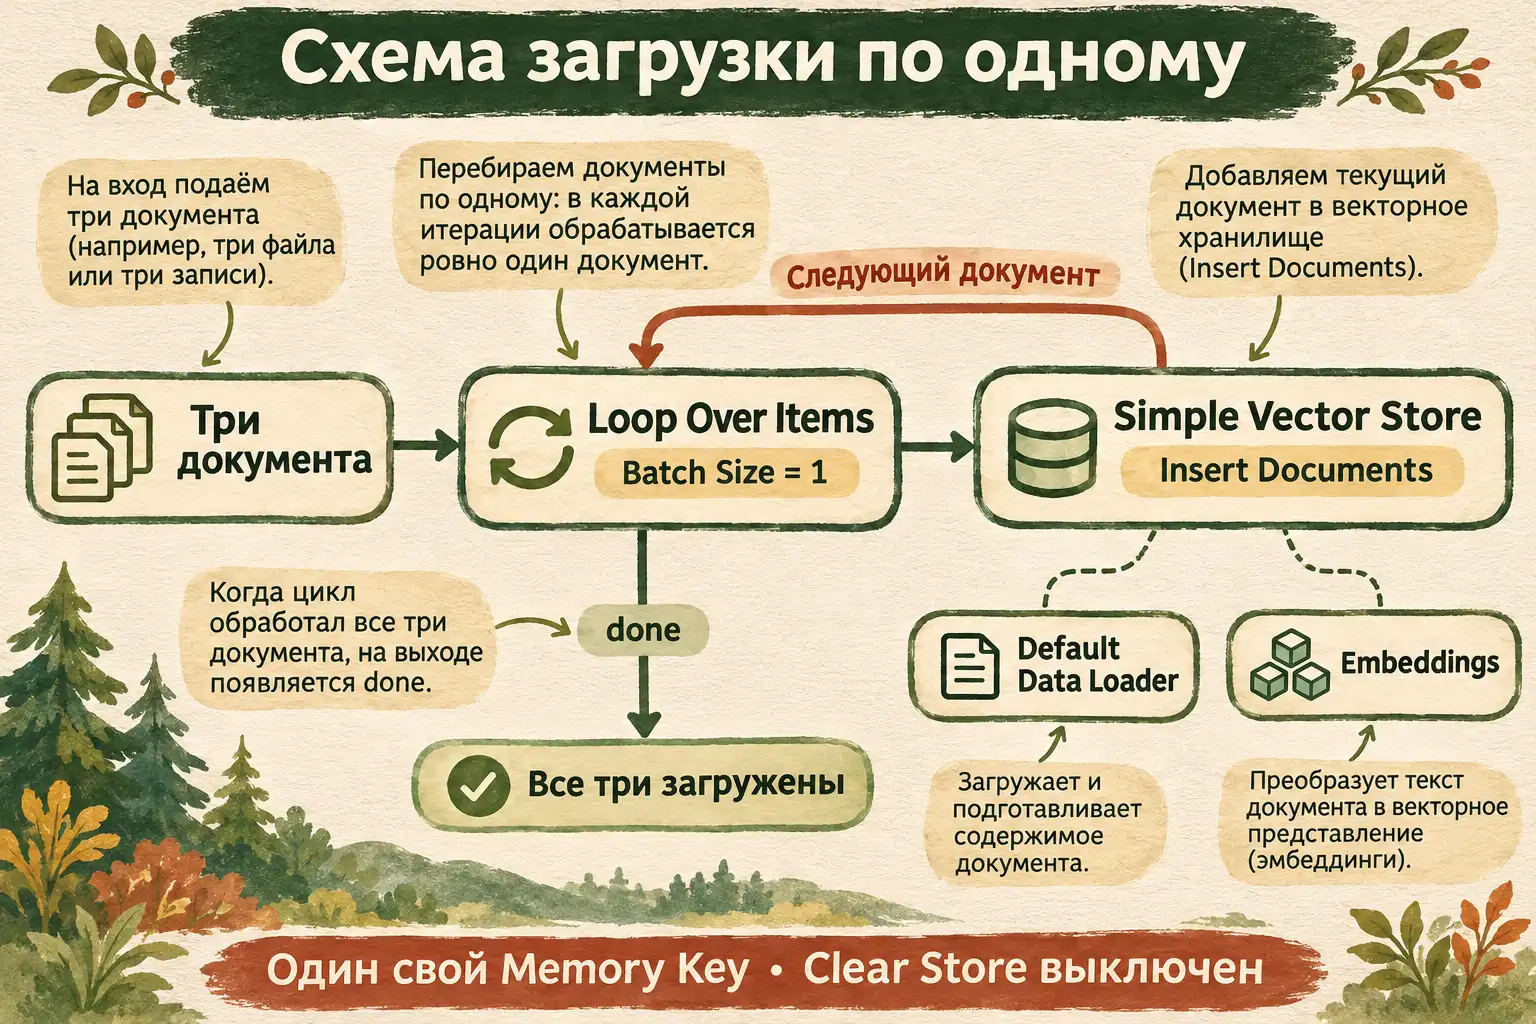 Обратная стрелка возвращает поток в цикл. Отдельный выход done показывает окончание всей загрузки.
Одна память и подпись каждого документа
В узле вставки задайте новый собственный Memory Key, например photo-notes-nikita-test-01, заменив его своим уникальным именем. Этот ключ нужно одинаково указать во второй части схемы. При полном повторе опыта создавайте новый свой ключ, чтобы не смешать старые и новые записи.
Clear Store оставьте выключенным на всех трёх вставках. Иначе включённая очистка может удалить уже загруженные документы по этому ключу. Чужой ключ для эксперимента не выбирайте.
К Simple Vector Store подключите Default Data Loader. Укажите тип JSON, режим Load Specific Data и текстовое выражение:
{{ $json.text }}В Metadata добавьте поле с именем id и значением:
{{ $json.id }}Выражения нужно вводить как выражения n8n, а не как буквальный текст с фигурными скобками. В просмотре подстановки у первой записи должен появиться её текст и D1; на следующем проходе — текст второй и D2. Метаданные сохраняют подпись, по которой мы позже узнаем источник.
Для трёх коротких фраз достаточно стандартного простого разбиения текста в загрузчике. К разъёму Embeddings у хранилища подключите выбранный Embeddings OpenAI и доступные Credentials. Сохраните точное название выбранной модели для второй части.
В настройках Loop Over Items оставьте Reset выключенным: опыт должен закончиться после третьей записи. Теперь выполните загрузку целиком и дождитесь выхода done. Если ошибка возникла на второй записи, откройте остановившийся узел и посмотрите его вход. Так у вас будет предмет для разговора с помощником: какая запись пришла, какое поле не заполнилось, что ответил узел. Третья строка в этой попытке могла ещё не попасть в память.
Поиск запускается после загрузки
Создайте вторую отдельную схему: Manual Trigger → Simple Vector Store. В ней выберите Get Many. Ручной запуск даёт один входной элемент для одного вопроса; список трёх документов сюда повторно передавать не нужно.
В Memory Key скопируйте своё имя из загрузки целиком. Похожее имя создаст поиск в другом месте: одна пропущенная буква здесь важнее самого красноречивого вопроса. Подключите ту же модель embeddings с теми же настройками, чтобы вопрос и документы сравнивались в одном представлении. В Prompt введите «В каком формате принимать изображения?», в Limit — 1. Включите Include Metadata, если такой параметр показывается в вашей версии, и проверьте, что выход содержит метаданные документа.
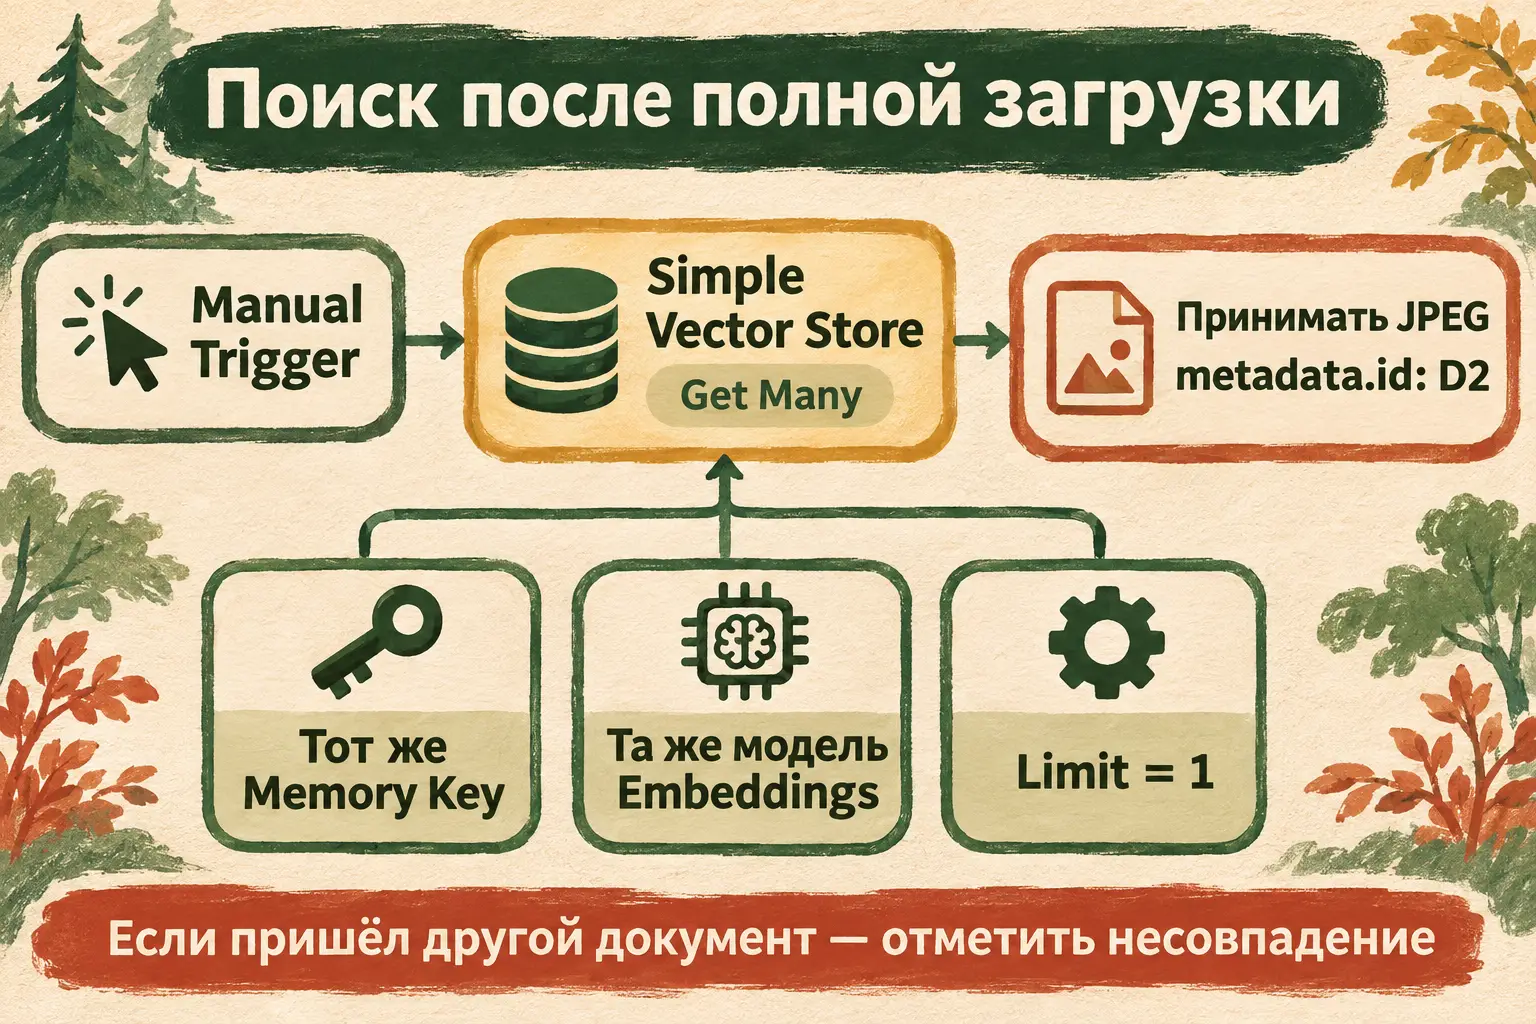 Результат сверяется с корпусом: для вопроса о формате ожидается запись D2 «Принимать JPEG».
Запустите поиск и прочитайте полученный фрагмент. Он должен действительно находиться среди исходных документов. Для нашего вопроса содержательное совпадение — «Принимать JPEG», а подпись источника — D2. Общий путь прямого поиска через Get Many описан в руководстве n8n по извлечению контекста.
Если пришёл D1 или D3, запишите несовпадение. Текст о вторнике не устанавливает формат изображения, даже если он занял первое место по близости. Увеличивать уверенность ответа здесь нечем; нужно выяснить, что загрузилось и как настроен поиск.
Начните разбор с простых развилок. Пустая выдача — повод сопоставить ключи и вспомнить, не перезапускался ли n8n. Выдача есть, но в ней день встречи — повод проверить все три прохода загрузки. Если трижды ушёл D1, посмотрите Batch Size и выражения загрузчика. Если исходные записи загружены правильно, сравните модель, формулировку вопроса и полученный текст.
Сохраните неудачную выдачу тоже: она показывает, что именно предстоит исправить. Вставленная от руки строка про JPEG сделала бы заметку красивее, но лишила бы вас этой подсказки.
Сохранить контекст, который можно показать другому
Скопируйте фактически найденный текст вместе с его id в отдельную заметку. Рядом оставьте вопрос и исходные три документа. Теперь другой человек сможет увидеть, почему фрагмент подходит или где возникло несовпадение. Для удачной попытки рядом окажутся вопрос о формате, строка «Принимать JPEG» и D2; для неудачной — честное описание того, что вернулось вместо неё.
Экспортируйте обе схемы из n8n и сохраните их рядом с корпусом и результатом. После перезапуска память может быть пустой: сохранённый экспорт восстанавливает устройство схемы, а повторная загрузка — её данные. Для нового полного опыта используйте новый собственный Memory Key.
Когда хочется добавить к поиску ответ собеседника, найденный фрагмент становится контекстом для следующего шага. Но сначала приятно получить этот маленький результат: задать вопрос своими словами и увидеть строку из своего материала с правильной подписью.
Если следующая задача — собрать логику помощника и его действия, пригодится разбор ИИ-агента в n8n. К нему удобно перейти, когда вы уже умеете получать подходящий фрагмент из своих материалов.
Несколько вопросов о первом поиске
Почему это называют поиском по смыслу?
В вопросе написано «формат изображения», а в нужной записи — «JPEG». Embeddings помогают сопоставлять близкие по смыслу тексты, даже когда слова не совпадают буквально. Полученное соответствие всё равно оценивают по содержанию: в маленьком корпусе это видно сразу.
Почему выбранная память пропала?
Simple Vector Store хранит её внутри работающего n8n, и перезапуск или очистка памяти могут убрать записи. Повторите загрузку своих сохранённых документов с новым ключом и используйте его в поисковой схеме. Для долговременной базы выбирают другой способ хранения; наш первый маршрут этого результата не обещает.
Будет ли ID означать правильный ответ?
ID сообщает, откуда пришёл фрагмент. Если D1 действительно содержит «Встреча во вторник», подпись верна, но для вопроса о формате документ не подходит. Правильность источника и полезность найденного текста проверяются вместе.
Три записки уже умеют отвечать на поиск
После выполнения сохраните рядом корпус, две схемы и фактически найденный фрагмент с источником. Следующую порцию собственных материалов можно добавлять, когда этот маленький опыт понятен: где появляется документ, чем подписывается и как находится.
В «Первопроходцах» можно постепенно разбирать подобные задачи с ИИ, задавать вопросы и доводить проекты с обратной связью. Раз в две недели проходят эфиры, проектные работы лично проверяет Никита. Условия участия помогут выбрать продолжение; свою среду и внешние модели подключают отдельно.
У соловья из старой шутки остаётся право помолчать. Наш маленький архив теперь можно расспросить и сверить с запиской. Если он вернёт JPEG, во вторник соберётся фотокружок. Если вернёт вторник вместо JPEG — у нас сохранён след, по которому найдётся причина.