У Куна царь Адраст видит двух героев: один укрыл доспехи львиной шкурой, другой — кабаньей. Он вспоминает прорицание и связывает слова «лев и кабан» с гостями перед собой. Снаружи видны шкуры, а внутри по-прежнему два человека со своими именами. Отдельно существует то, что Адраст увидел, отдельно — вывод, который сделал. В проверке помощника удобно сохранить обе части такого перехода.
Допустим, у вас уже работает учебный помощник по записям кружка бумажных моделей. Он ищет подходящий документ, затем отвечает по найденному. Вы спрашиваете, что принести на встречу, и получаете связный текст. Бумага, клей, ножницы — всё выглядит знакомо. А если помощник от себя добавил степлер, вы обнаружите его уже на столе, рядом с бумажным парусником. Кто-то спросит, где скреплять мачту. Если поручить степлеру свободную интерпретацию, бумажный флот скоро отправится в плавание с железной оснасткой. Прежде чем менять инструкцию кружка, хочется узнать, в какой записи вообще нашёлся этот инструмент. Но как понять, нашёл ли он нужную запись и не добавил ли к ней лишнего?
Один удачный ответ приятно прочитать. Небольшой постоянный набор вопросов позволяет вернуться к тем же местам после изменения процесса. Сделаем таблицу: рядом с ожиданием останутся фактически найденные документы и фактический ответ. По ней будет видно, какое действие исправлять дальше.
Тестирование RAG начинается с известных записей
RAG здесь — процесс, который сначала извлекает материал из корпуса, а затем использует его при ответе. В этой статье сам процесс уже существует в доступной среде n8n. Для проверки нужны его вход для вопроса, выход извлечения с ID документов и текстовый ответ.
Описанный режим быстрых оценок доступен в n8n Cloud на всех планах и в самостоятельной Registered Community, Business или Enterprise. Это указано в документации быстрых проверок. Используйте свою уже поддерживаемую среду с нужными узлами и разрешениями; новая регистрация или создание векторной базы в этот путь не входят. Если модель в процессе тарифицируется отдельно, три проверки используют её обычные вызовы.
Возьмём две короткие записи известного учебного корпуса. D1 и D2 — устойчивые метки источников, по которым мы узнаём, что нашлось:
D1. Встречи кружка. Кружок бумажных моделей собирается по субботам в 11:00 в комнате 2.
D2. Материалы. Для встречи нужны бумага A4, клей-карандаш и ножницы.
В этих двух записях нет стоимости занятий. Для своей проверки используйте такие же понятные вопросы к уже загруженному учебному корпусу. Сначала прочитайте записи сами и выпишите ответ, а потом запускайте помощника. Тогда ожидание существует независимо от того, что он скажет.
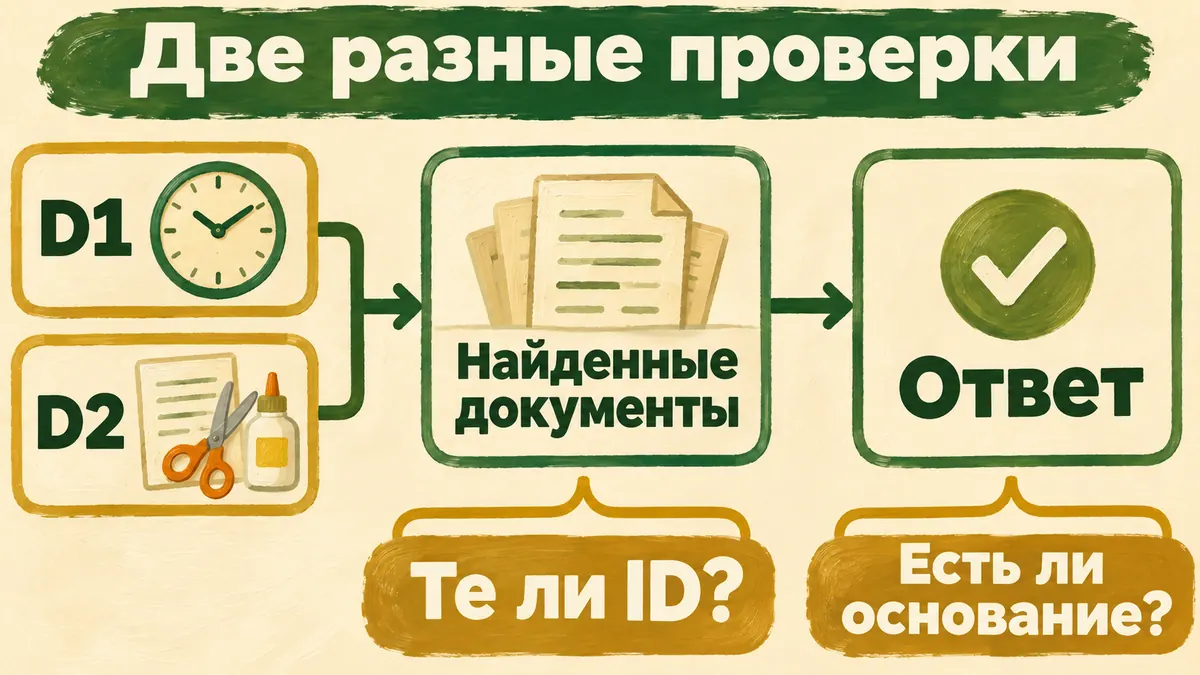
У поиска спрашиваем «те ли документы?», у ответа — «есть ли в них основание для фразы?».
Наши вопросы: когда собирается кружок, какие нужны материалы и сколько стоят занятия. Для первых двух есть определённые записи. Для третьего нужный результат — сообщить, что цена в данном корпусе не указана. Сумму за автора документов дописывать не будем.
Таблица, в которой ожидание стоит рядом с фактом
В своём проекте n8n откройте вкладку Data tables. В правом верхнем меню создания выберите Create Data table и создание с нуля, From scratch. Назовите таблицу, например «Проверка кружка». Путь описан в справке Data tables.
Добавьте пять текстовых столбцов. Их имена нужны узлам для сопоставления, поэтому сохраните написание:
| Столбец | Что в нём хранится |
|---|---|
| input | Вопрос, который получает процесс |
| expected_ids | Какие документы содержат основание для ответа |
| expected_answer | Смысл правильного ответа |
| actual_ids | ID, фактически полученные при извлечении |
| actual_answer | Фактический текст ответа |
В первые три столбца внесите три строки. Два последних пока оставьте пустыми — их заполнит запуск, а не наше ожидание.
| input | expected_ids | expected_answer |
|---|---|---|
| Когда собирается кружок? | D1 | По субботам в 11:00 |
| Какие материалы нужны? | D2 | Бумага A4, клей-карандаш, ножницы |
| Сколько стоят занятия? | нет | Цена в корпусе не указана |
Слово «нет» в третьей строке означает отсутствие документа с ценой. Оно не требует, чтобы поиск обязательно вернул пустой список: иногда тот приносит похожую запись о встрече. Мы отдельно посмотрим, содержит ли она ответ на вопрос и как обошлась с этим модель.
Небольшого набора пока достаточно, чтобы пройти весь путь и получить понятную таблицу. Результат этой пробы относится к выбранным трём вопросам. Следующий набор можно пополнить другими трудностями уже из своего материала, сохранив такой же способ сравнения.
Подключаем вопросы к существующему процессу
Откройте учебный workflow в редакторе. Добавьте Evaluation Trigger. В его параметре Source выберите Data table, а затем таблицу «Проверка кружка». Это источник строк для запуска. По описанию Evaluation Trigger каждый проход получает одну строку.
Для первого подключения включите Limit Rows и поставьте Max Rows to Process равным 1. Запустите только этот узел через Execute node. В его выходе должна появиться первая строка с полем input. Сейчас мы проверяем, что таблица читается, ещё до полного прохода через модель.
Соедините выход триггера со входом существующего учебного процесса. В том месте, где раньше задавался вопрос, выберите значение input из выхода Evaluation Trigger. Сопоставьте это поле со своим входом вопроса. Сами expected_answer и expected_ids модели не передавайте: они нужны для проверки результата.
Если в процессе уже есть другой триггер, работайте с отдельной учебной веткой, для которой понятен вход вопроса. Схему двух входов нужно согласовать с устройством вашего workflow. На этом месте удобно подключить помощника: универсальное название следующего поля не заменит структуру конкретного процесса.
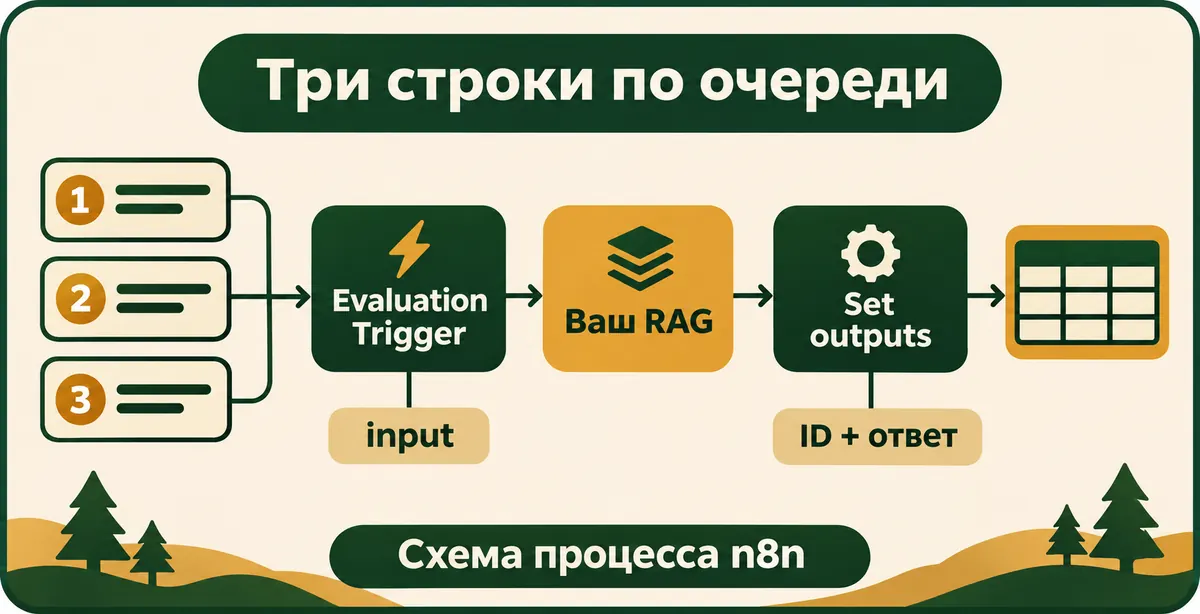
Схема процесса n8n. Сравниваемые ожидания остаются в таблице, вопрос идёт в работающий RAG.
После выхода процесса добавьте узел Evaluation и выберите операцию Set outputs. Укажите Source: Data table и ту же таблицу. В разделе Outputs настройте два назначения: actual_ids получает реальные метки из выхода извлечения, actual_answer — готовый текст ответа. Названия и значения операции описаны в справке Evaluation.
Метки берите из найденных документов, например из их поля id или метаданных. Название зависит от вашего процесса. Не подставляйте в actual_ids список источников, который сама модель вписала в свой текст: иначе потеряется возможность увидеть, что реально извлекалось. Если на последнем узле остался только ответ, сопоставьте ID с выходом предыдущего узла извлечения.
Помощник разберёт именно ваш выход
В обычном чате DeepSeek можно показать обезличенную структуру одного запуска и спросить, как сопоставить два результата. Начните так:
У меня уже работает учебный RAG в n8n. Подключаю Evaluation Trigger и Data Table со столбцами input, expected_ids, expected_answer, actual_ids, actual_answer. Нужно подать только input в процесс и через Evaluation: Set outputs записать найденные ID из извлечения и текст ответа. Сначала уточни версию n8n и структуру моего входа/выхода. Затем предложи одно действие: что открыть, какое значение сопоставить и что должно появиться. Жди результата. Вот очищенный пример структуры: [поля без ключей и персональных данных].
Вставьте сообщение в поле чата. На первом ответе помощник уточнит версию или попросит нужную часть структуры. Затем проходите одно сопоставление за раз. Названия подключений, токены и пароли ему не передавайте; для задачи достаточно имён полей и вымышленных значений.
После первого полного прохода откройте строку таблицы. В actual_ids должны быть найденные метки, в actual_answer — настоящий текст этого прохода. Если туда попало ожидание или слово «успешно», исправьте сопоставление до общего запуска. Нам нужны сами результаты, чтобы прочитать их своими глазами.
Запускаем все строки и читаем расхождения
Вернитесь к Evaluation Trigger. Отключите ограничение одной строкой и убедитесь, что фильтр не исключает две остальные. Нажмите Evaluate all у триггера. В текущей справке общий запуск также показан кнопкой Execute workflow возле него; ориентируйтесь на запуск всего набора в своём редакторе. Строки должны пройти процесс последовательно.
Откройте таблицу. У всех трёх вопросов должны появиться фактические результаты. Пустая ячейка после незавершённого запуска ещё ничего не говорит о качестве ответа: сначала посмотрите execution этой строки и доведите проход до записи результата.
Для первой строки проверьте, есть ли среди найденного D1, затем прочитайте ответ. Он должен сохранить субботу и 11:00. Для второй проверьте D2 и три материала. Ответ можно сформулировать разными словами, но замена клея на степлер уже меняет содержание.
Теперь третий вопрос. Даже если поиск принёс D1 или D2 как близкий материал, ни в одном нет цены. В ответе должно остаться это отсутствие. Если там появилась сумма, отметьте ошибку основания ответа отдельно от состава найденных документов.
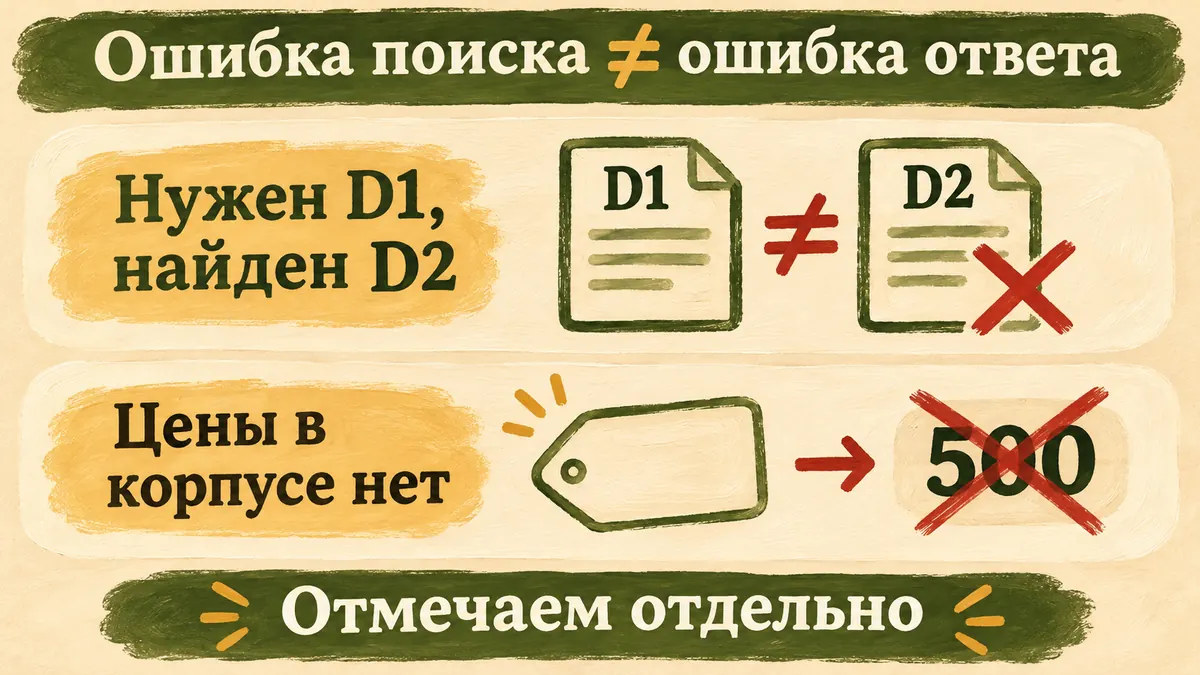
Авторские примеры диагностики, не результаты запуска сервиса. Неверный документ и придуманная цена отмечаются раздельно.
Допустим, при вопросе о времени извлёкся только D2, а ответ всё равно назвал субботу. Красивое совпадение с ожиданием не исправляет поиск: у полученной фразы нет опоры в найденном документе. Запишите две заметки — «не найден D1» и «время названо без найденного основания». Теперь видно, что удачно названное время маскировало сразу две проблемы. Если сохранить только совпавший ответ, следующая правка поиска останется без проверки. Два отдельных поля удерживают это расхождение на виду.
Можно встретить и обратное: D1 найден, но модель ответила про воскресенье. Тогда источник доступен, а содержание исказилось при ответе. Сначала сохраните эту строку, затем меняйте одну нужную часть процесса и запускайте тот же набор снова. Не заменяйте проверку вопросом к модели «ты всё сделала правильно?».
Сохраняем таблицу, с которой можно вернуться
Добавьте к своим заметкам причину каждого расхождения и дату прохода. Перед следующим запуском скачайте CSV таблицы через её меню с тремя точками → Download CSV. Так старые фактические результаты останутся отдельно от следующей версии. Сохраните также известные D1/D2 и формулировки вопросов.
Сам workflow скачайте как JSON через меню с тремя точками в заголовке редактора → Download. Перед передачей другому человеку очистите экспорт от чувствительных названий подключений и вручную вписанных заголовков авторизации. Эти особенности экспорта перечислены в документации n8n.
Теперь у вас есть повторяемая вещь: набор, наблюдённые выходы и схема процесса. Если интересует сам выбор следующего поиска, можно перейти к объяснению Agentic RAG. А для более простого первого процесса с текстом пригодится автоматизация с ИИ в n8n, когда ещё хочется освоить вход, выход и сверку с исходником.
В условиях участия в «Первопроходцах» можно посмотреть, как устроены постепенные уроки, вопросы и работа над собственным проектом с ИИ. Таблица конкретных расхождений пригодится для следующего разбора.
Вопросы и ответы
Обязан ли ответ совпадать с эталоном слово в слово?
Для ручной проверки здесь важен смысл: день, время и материалы. Перестановка слов допустима, новый факт требует основания. Именно поэтому actual_answer сохраняется целиком, а не заменяется одной зелёной отметкой.
Похожие документы по третьему вопросу — уже ошибка?
Сначала прочитайте, что нашлось. Близкий по теме текст может не содержать цены. Отметьте отсутствие основания и отдельно посмотрите, признала ли это модель. Значение «нет» в expected_ids обозначает отсутствие подтверждающего источника, а не универсальное требование пустого результата поиска.
Почему нет общей оценки качества в процентах?
На этих трёх вопросах полезнее увидеть конкретные расхождения. Сначала добейтесь, чтобы все строки сохранили настоящие выходы и у каждой ошибки была причина. Числовые метрики можно добавить позже, когда выбран набор и понятно, что именно они измеряют.
Две записи о кружке снова лежат перед вами. Время нашлось в одной, материалы — в другой, цена пока никем не названа. Помощнику не пришлось становиться оракулом: достаточно найти нужную запись и удержать ответ в её пределах. Степлер тоже можно вернуть в ящик: в списке материалов он пока не появился. Сначала проверим запись, а мачту приклеим тем, что действительно названо. Следующее улучшение процесса теперь начинается с конкретной строки.