Гамлет спрашивает могильщика, чья перед ним могила. «Моя, сэр», — отвечает тот: ведь именно он сейчас в ней стоит. Принц хочет узнать, для кого её роют, а собеседник держится за другое значение вопроса. Общие слова уже нашлись, нужного сведения всё ещё нет. Гамлет замечает, как легко здесь пропасть от двусмыслиц. Приходится уточнять, что именно спрашиваешь.
У домашнего прибора тоже бывает такая минута славы. Вы спрашиваете об уходе за ZX-14, и помощник приносит инструкцию про фильтр: всё по теме, даже картинки знакомые. Только модель другая. Одна инструкция велит фильтр менять, другая — очищать; знакомое слово радостно соединило несовместимые роли. На сцене по-прежнему фильтр, но пьеса уже чужая.
Разберём поиск на трёх коротких строках. Вы сможете сами проверить совпадения, задать помощнику два разных вопроса и увидеть, где требуется буквальная точность. Устанавливать базу данных для этого не нужно.
Три строки и один нужный код
Возьмём такие записи. Обозначения D1, D2 и D3 нужны только затем, чтобы не потерять, откуда взялась фраза.
| Запись | Текст |
|---|---|
| D1 | Код ZX-14: менять фильтр раз в месяц |
| D2 | Как очистить фильтр другой модели |
| D3 | Регистрация на встречу |
Начните с вопроса «ZX-14». Прочитайте строки глазами или воспользуйтесь обычным поиском по странице: Ctrl+F на Windows, Command+F на Mac. Вставьте обозначение целиком. Оно встречается в D1. Это ручная проверка точного появления кода; её можно выполнить ещё до разговора об алгоритмах.
Теперь задайте вопрос «как обслужить устройство». Таких слов в трёх строках нет. При этом человеку понятно, что замена и очистка фильтра могут относиться к обслуживанию. Вопрос стал шире: он требует связать разные формулировки. А выбор между D1 и D2 всё ещё зависит от модели.
Именно здесь разделяются два полезных свойства поиска: найти знакомые буквы и узнать ту же мысль, выраженную иначе. Вопрос «как обслужить ZX-14» просит об обоих сразу.
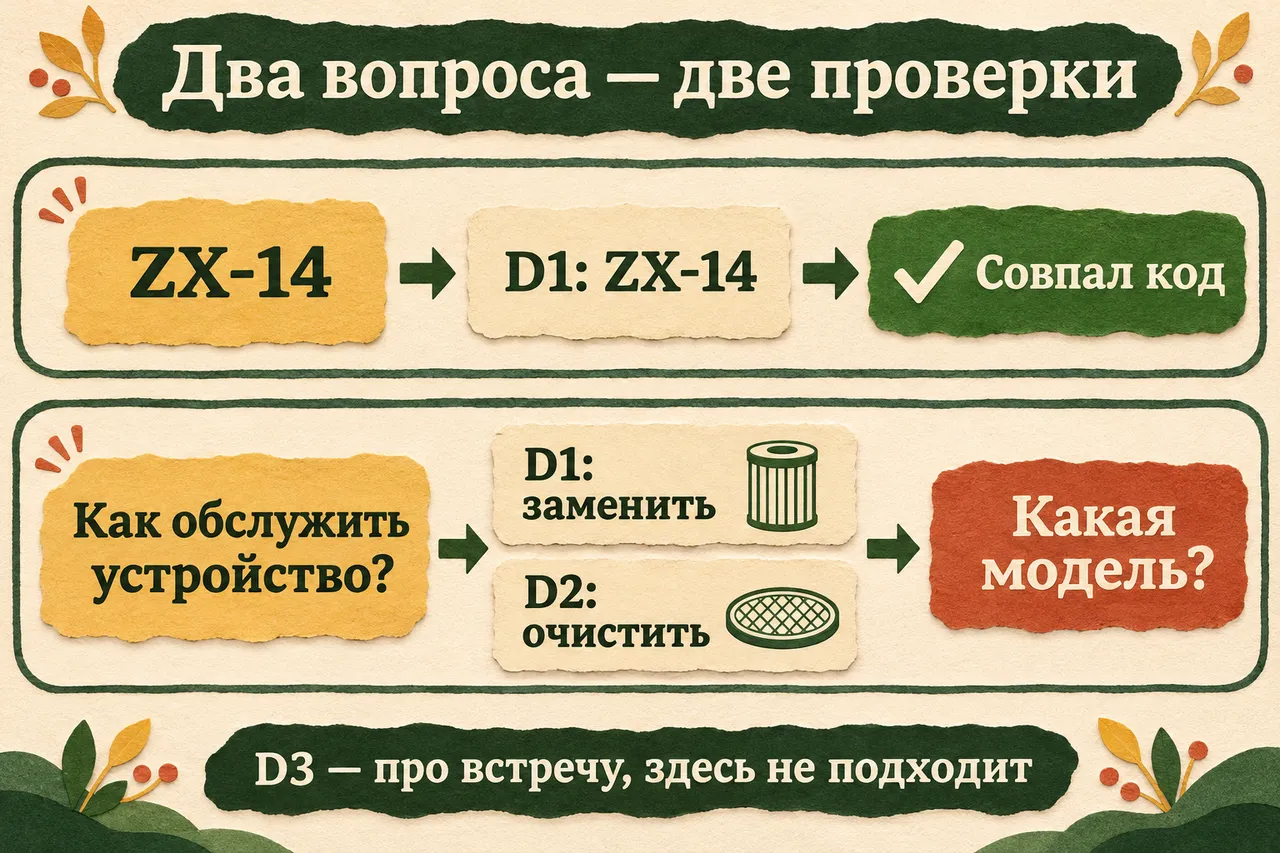
Схема задачи: совпадение кода можно проверить прямо в тексте. Результат настоящей смысловой модели здесь не показан.
Что замечает поиск по словам
Лексический поиск работает с терминами, полученными из запроса и документов. BM25 — один из способов оценить, насколько найденный текст подходит запросу. Он использует статистику слов; нейросеть для такого подсчёта не требуется. В документации Elasticsearch этот способ описан среди моделей ранжирования.
В пачке инструкций слово «устройство» может встречаться на каждой странице. Оно указывает на целый зал, а редкое обозначение модели помогает найти нужное место. Внутри текста учитывается частота термина, причём польза повторов постепенно насыщается. Если автор десять раз выкрикнул название с обложки, содержание от этого десятикратно полезнее не стало.
Ещё имеет значение длина текста. В большом документе больше мест, где слово могло встретиться случайно, поэтому алгоритм учитывает длину относительно остальных документов. Под документом здесь может пониматься и целая инструкция, и отдельный фрагмент, который система положила в индекс.
Эти свойства помогают ранжировать кандидатов. Само совпадение букв остаётся отдельной проверкой: для нашего D1 достаточно глазами прочитать ZX-14. Если вы хотите найти именно целый код, важен и способ хранения обозначения. Поисковая система может разбирать текст на части, менять регистр, обрабатывать дефис. Поэтому после поиска откройте строку и сверяйте полное написание. Когда собирают собственную систему, для кода часто предусматривают отдельное поле с точным сопоставлением.
Лексический подход полезен там, где одна буква меняет предмет: модель прибора, артикул детали, фамилия, номер документа. На похожую формулировку можно согласиться. На похожий номер заказа обычно уже не хочется.
Когда человек спрашивает своими словами
Смысловой поиск нужен для другого удобства: вы помните задачу, но забыли, какими словами она записана. «Подготовить к хранению» может привести к разделу о консервации, а «не держит заряд» — к материалу об аккумуляторе. Такой поиск сравнивает числовые представления содержания — векторы. Обзор Azure AI Search объясняет этот путь через близость представлений запроса и документов.
Для наших строк вопрос об обслуживании заставляет рассматривать и замену, и очистку фильтра. Это человеческое рассуждение о примере, а не показ результата запущенной embedding-модели. Чтобы узнать её порядок кандидатов, нужно действительно выполнить поиск выбранной моделью по подготовленному индексу.
Практический вывод можно получить и без такого запуска. D2 говорит об очистке, но прямо относится к другой модели. Сходство темы ещё не даёт основания перенести действие на ZX-14. В D1 указана нужная модель и другое действие — замена. Значит, в ответе нужно удержать связь между кодом и инструкцией.
Проверьте это вместе с ИИ. Откройте DeepSeek, вставьте три строки и такой запрос:
Помоги мне разобраться с поиском по этим записям. Для вопроса «ZX-14» покажи точное совпадение и процитируй строку. Для вопроса «как обслужить устройство» объясни, какие записи близки по смыслу и чего не хватает для выбора модели. Не назначай поисковые баллы. Затем ответь на вопрос «что записано об обслуживании ZX-14», опираясь только на эти строки. Рядом с каждым выводом поставь D1, D2 или D3. Если нужной записи нет, так и скажи.
Понятный результат — ответ с опорой на D1: в записи сказано менять фильтр раз в месяц. D2 не подтверждает, что фильтр ZX-14 следует очищать, а D3 к вопросу отношения не имеет. Если помощник советует промыть деталь, спросите: «Покажи строку, из которой следует именно это действие для ZX-14». Когда подходящей цитаты нет, исправьте вывод вместе с ним: в доступной записи сказано о замене. У вас появился способ остановить ошибку на конкретной фразе, ещё до того, как чужая инструкция превратилась в собственный план действий.
Для реального прибора возьмите его собственную актуальную инструкцию. Наши три строки позволяют понять устройство поиска; они не содержат модели настоящего устройства и полного порядка работ.
Два списка сходятся в один
Гибридный поиск соединяет два пути: по словам и по смыслу. В Azure они выполняются параллельно, а затем результаты объединяются; это описано в обзоре гибридного поиска. Точное обозначение помогает одному пути, свободный человеческий вопрос — другому.
Вообразим два списка кандидатов, которые нам передали для дальнейшей работы. В первом лежат D1 и D2, во втором — D2 и D1. Это схема объединения списков, без рассчитанных оценок и без утверждения, что поисковый движок вернёт именно такой порядок. После объединения у нас остаются две разные записи. Второй экземпляр D1 не становится ещё одним подтверждением.
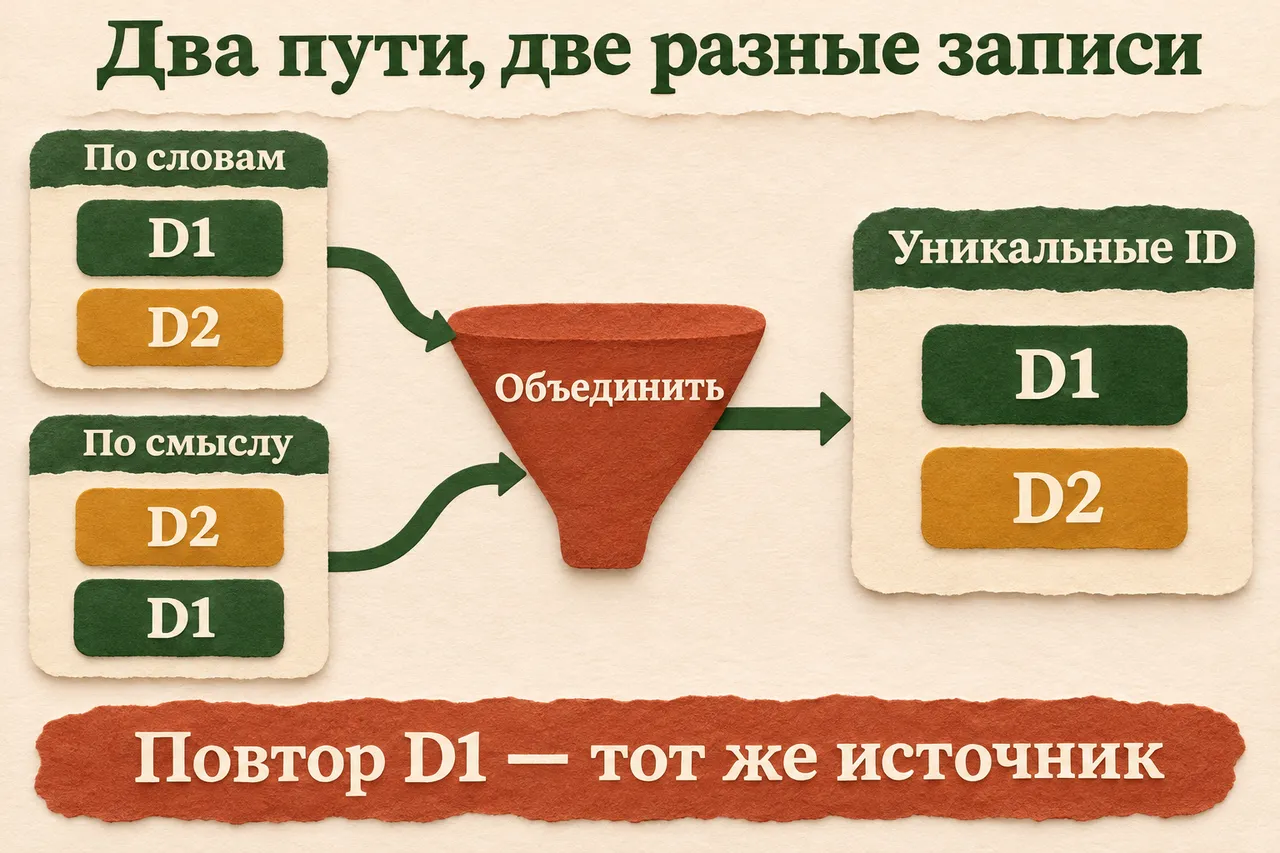
Схема объединения кандидатов: одинаковый ID обозначает тот же самый фрагмент. Порядок нарисован для объяснения, поисковые баллы не рассчитывались.
В рабочей системе нужно ещё решить, как упорядочить объединённый результат. Например, Azure использует слияние по позициям в списках — RRF. Начинающему достаточно понимать причину: оценки разных способов поиска живут на разных шкалах, поэтому просто складывать их как одинаковые величины нельзя. Способ слияния выбирают и проверяют на своих вопросах.
После слияния откройте сами записи. Две найденные копии D1 легко принять за хор согласных экспертов: все уверенно говорят одно и то же. Приглядитесь — это один суфлёр пересел из левой ложи в правую. Сохраните его ID один раз и проверьте, что в тексте действительно названы нужная модель и действие. Совпадение маршрутов полезно, независимого подтверждения оно не прибавляет.
Где здесь RAG и почему ответ ещё впереди
RAG — устройство работы, при котором помощнику сначала находят подходящие материалы, а затем предлагают составить ответ с их опорой. Поиск занимает внутри этого пути своё место. Он может быть лексическим, векторным или гибридным. Поэтому выбор BM25 не исключает такую архитектуру: алгоритм помогает на этапе извлечения.
Представим, что в контекст ответа попала только D2. Помощник подробно объяснит очистку, разложит её по шагам и предложит удобный список. Чем яснее такой ответ, тем легче пройти мимо потерянного обозначения. Ошибка началась ещё при выборе инструкции. Верните в проверку вопрос «для какой модели это действие?» — и станет видно, что D2 не даёт ответа про ZX-14.
Если нужная D1 вообще не попала в кандидаты, перестановка найденных фрагментов её туда не добавит. Для BM25 в RAG сначала стоит проверить, дошёл ли нужный текст до этапа ответа. Упрашивать помощника «будь внимательнее» рано: посмотрите, дали ли ему инструкцию, которую он должен был заметить.
Когда D1 в кандидатах есть, но помощник всё время начинает с D2, проверьте порядок и отбор перед ответом. Повторная оценка уже найденных фрагментов называется reranking. Она решает следующий вопрос: чему отдать внимание среди того, что уже удалось получить. У этих двух ошибок разные места ремонта.
Для общей картины полезно сравнить поиск по материалам и дообучение модели. Этот вопрос появляется, когда вы решаете, как вообще дать помощнику собственную информацию. Здесь же мы уже выбрали поиск и выясняем, какую запись он должен принести.
Выберите проверку под свой вопрос
Сначала сформулируйте, что обязательно должно сохраниться в ответе. Для вопроса с моделью — её обозначение. Для вопроса по забытой формулировке — подходящий смысл. Если нужны оба свойства, проверьте их раздельно, а потом вместе.
| Вопрос | Точное условие | Какой подход рассмотреть | Что проверить в найденном |
|---|---|---|---|
| ZX-14 | Полный код без замены символов | Лексический поиск; точное поле для кода при необходимости | Код действительно стоит в D1 |
| Как обслужить устройство | Действие относится к обслуживанию | Смысловой поиск или расширение формулировки | Какая модель названа в источнике |
| Как обслужить ZX-14 | И действие, и нужный код | Гибридный поиск с проверкой обозначения | Действие для этой модели, а не для похожей |
На своей папке начните с нескольких вопросов, ответы на которые можете проверить сами. Сохраните вопрос, найденный фрагмент и подходящую цитату. Один запрос пусть содержит точное обозначение, другой — привычные слова вместо терминов. Если система справилась с одним, это ещё не отвечает на второй вопрос: теперь вы знаете, что именно сравнить.
Такой набор полезен и в разговоре с разработчиком. Покажите рядом свой вопрос, нужную запись и фактических кандидатов. Тогда можно выяснить, потерялся ли код при обработке текста, не хватает ли смыслового пути или помощник плохо использовал уже найденный фрагмент.
Если текст нашёлся, а ответ всё равно съезжает к соседней модели, попробуйте получить инструкцию из предоставленного источника. Этот следующий шаг пригодится, когда поиск уже сделал свою часть работы и нужно удержать ответ в пределах найденного материала.
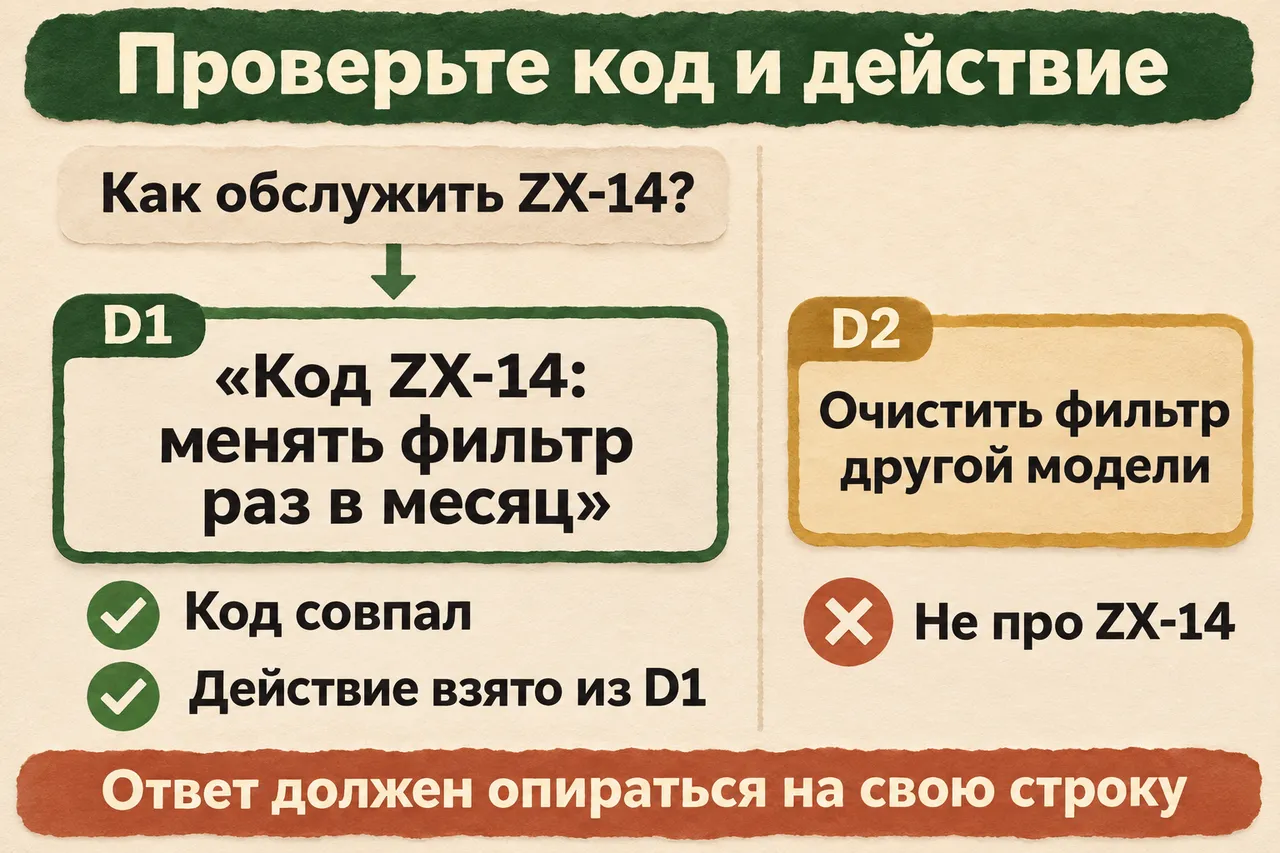
Схема проверки: код, действие и цитата должны оставаться связанными. Поисковая оценка эту связь не заменяет.
Если вы уже настраиваете поисковую систему
У BM25 есть параметры k1 и b. Первый управляет насыщением вклада повторов, второй — влиянием длины документа. Их смысл и значения по умолчанию приведены в справке Lucene. Это настройки ранжирования текстов, а не творчества или случайности ответа нейросети.
Не начинайте знакомство с подбора этих чисел. Сначала проверьте, попадает ли нужный фрагмент в индекс, сохраняется ли код при анализе текста и есть ли подходящая запись среди результатов. Для схемы, которая не получила D1, изменение красноречия ответа не решит вопрос с моделью.
Частые вопросы
Достаточно ли обычного поиска по странице?
Для трёх строк и одного известного кода — да. Он даст маленький проверяемый результат сразу. Алгоритм ранжирования нужен, когда совпадений и документов больше, чем удобно просматривать вручную. Ручная проверка остаётся способом понять, какое совпадение вы ожидаете.
Смысловой поиск всегда понимает вопрос лучше?
Он полезен для перефразирования, но итог зависит от модели, материала и подготовки индекса. Для обозначения с похожими соседями сохраняйте отдельную проверку точного кода. Выбор по смыслу и принадлежность нужной модели отвечают на разные вопросы.
Можно ли попросить чат показать баллы BM25?
Для настоящих баллов нужны выбранная реализация, обработка текста, состав индекса и расчёт. В нашем упражнении чат помогает разобрать строки и проверить цитату. Придуманные числа не добавят к этому разбору полезной точности.
Два найденных экземпляра D1 подтверждают ответ сильнее?
Это два пути к одной записи. Сохраните один ID и исходный текст. Для независимого подтверждения понадобится другой источник, а не ещё одна копия той же строки.
Возьмите свой вопрос с точным обозначением и найдите для него одну проверяемую строку. Когда код, действие и цитата сошлись, поиск сделал полезное дело. Фильтр может вернуться в прибор. За точным кодом нашлось нужное действие, а могильщиковы двусмысленности остались на странице пьесы.