Нитобэ видит в устройстве одного слова повод уйти далеко — к древней философии, где логос связывали со словом и разумом. У нас путь короче: задержимся на обычном «она». Оказывается, даже это маленькое слово способно задержать две чашки чая над столом. Одна родственница уже поздравляет Олю, другая ищет в переписке фотографию Иры с медалью.
Допустим, после школьного конкурса в семейный чат пришло сообщение: «Оля рассказала Ире, что она выиграла». Выиграла Оля? Или Ира? Кому отправлять поздравление с кубком? Пока семейный чат выбирает, бабушка может заказать торт с надписью «Поздравляем её» — дипломатическое решение, которое не помещается ни в чью коробку с наградами. Оба имени подходят к местоимению, а на фотографии приза подписи нет. Посмотрим, как технический механизм внимания позволяет учитывать связи между частями текста.
Для первого знакомства не нужны установка модели и программирование. Достаточно этой фразы, трёх карточек и простого умножения. В конце вы сможете объяснить, что означает вес связи, пересчитать один результат и задать нейросети вопрос о другом коротком предложении.
Нейросеть-трансформер связывает представления, пока мы читаем слова
Трансформер получает текст кусочками — токенами. Кусочек может совпадать со словом, быть частью слова или знаком. Чтобы увидеть саму идею, пока будем считать целое слово одним элементом. В настоящей модели разбиение нашей русской фразы может получиться мельче.
На входе трансформера каждый элемент представлен набором чисел, вектором. Внимание позволяет обновить этот набор с учётом других доступных элементов. Например, при обработке «она» могут участвовать представления имён и остальных частей фразы; их вклады получают разные коэффициенты.
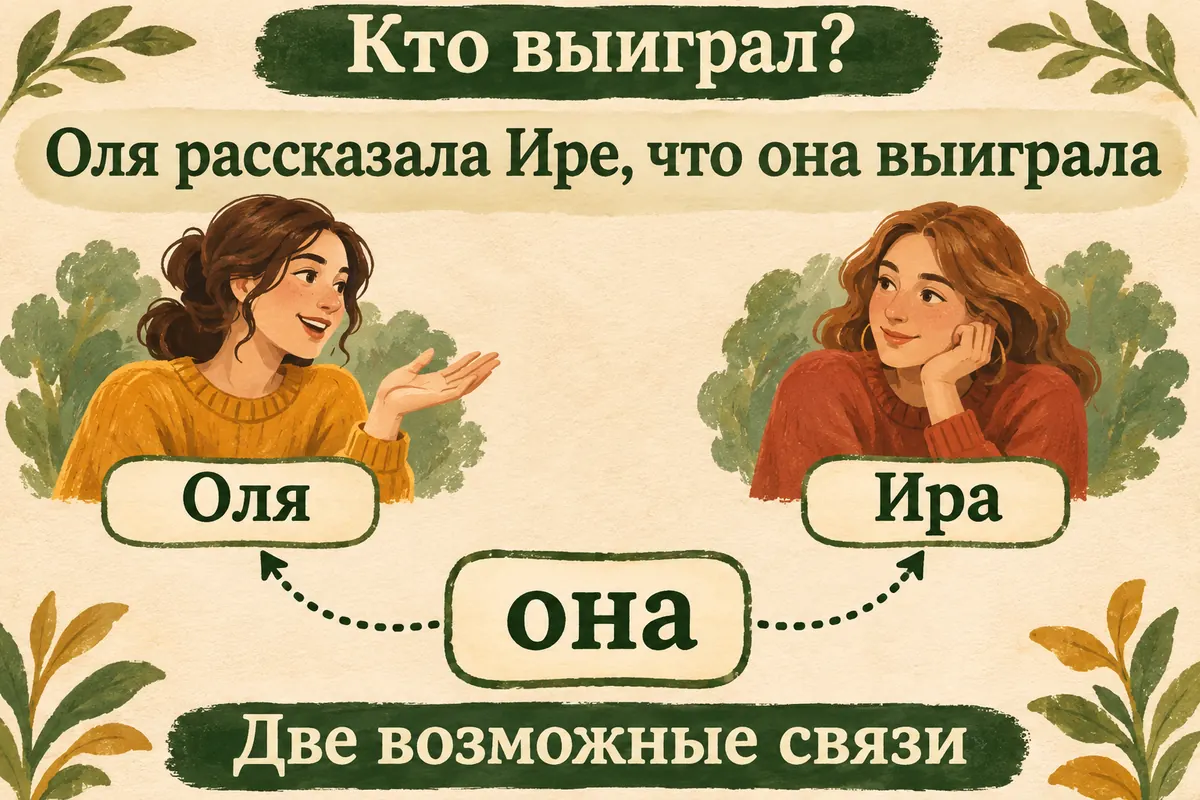
Одна фраза допускает два прочтения. Стрелки показывают возможные связи, а не извлечённое внимание какого-либо чата.
В трансформере самовнимание, или self-attention, связывает элементы одной последовательности. Слово «само» здесь относится к последовательности: её части взаимодействуют друг с другом. В объяснении Google похожий вопрос разобран на неоднозначном местоимении в английском предложении.
Для нашей семейной заметки полезно уже это открытие: местоимению нужен контекст. Но трансформер работает с числовыми представлениями; разговорное «модель обратила внимание на Иру» — удобное сокращение для вычисления.
Если сами числовые веса пока непривычны, можно начать с объяснения весов нейросети. Здесь нас интересует отдельная операция: как собрать новое представление из нескольких исходных.
Три карточки и один набор весов
Выделим из фразы только три элемента: «Оля», «Ира», «она». Остальные слова пока оставим за пределами расчёта. Это маленькая авторская иллюстрация: все коэффициенты ниже заданы нами для разбора, а не получены из работающей языковой модели.
Представьте лист с тремя строками. В каждой строке указано, с какими долями мы будем брать информацию от трёх карточек. Для строки «она» выберем: от Оли — 0,2; от Иры — 0,7; от самого местоимения — 0,1. Вместе получается единица: 0,2 + 0,7 + 0,1 = 1.
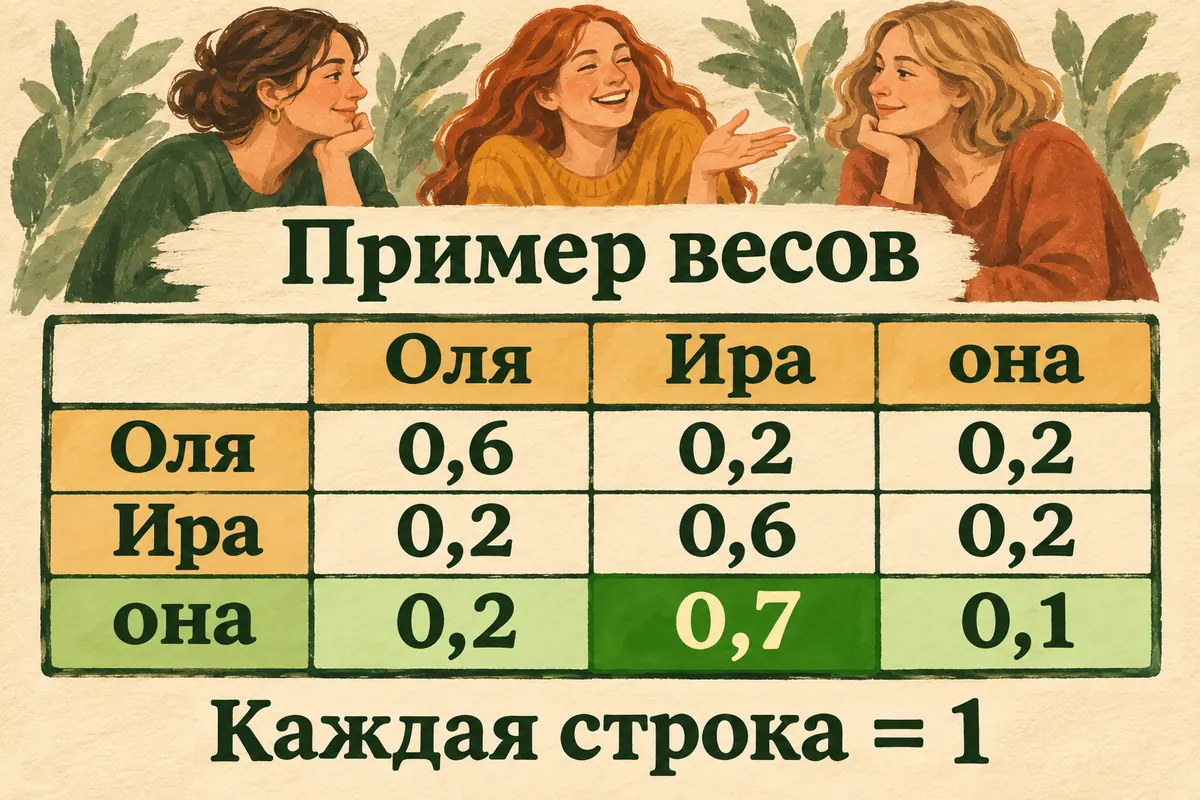
Строка задаёт получателя нового представления, столбец — откуда берётся вклад. Числа выбраны для наглядности.
| Для какого элемента считаем | Вклад Оли | Вклад Иры | Вклад «она» | Сумма строки |
|---|---|---|---|---|
| Оля | 0,6 | 0,2 | 0,2 | 1 |
| Ира | 0,2 | 0,6 | 0,2 | 1 |
| она | 0,2 | 0,7 | 0,1 | 1 |
У каждой строки своё распределение. Нам особенно интересна последняя: в ней больше всего веса приходится на Иру. Это означает только, что в заданной нами смеси её числовое представление участвует сильнее остальных. Вероятность победы Иры по этой таблице мы не вычисляли.
Есть ещё деталь: строка и столбец отвечают на разные вопросы. Ячейка «она → Ира» показывает вклад Иры в обновление «она». Обратная ячейка стоит в другом месте и может иметь другое число. Если читать таблицу как список взаимных симпатий, придётся выяснять, почему Ира получила от местоимения больше внимания, чем вернула. Но наша таблица описывает направление числового вклада; обидеться в ней некому.
Получим результат, который можно пересчитать
Теперь каждой карточке дадим очень короткое числовое представление из двух координат. Для Оли возьмём [1; 0], для Иры — [0; 1], для «она» — [0,5; 0,5]. Координаты придуманы для счёта и не называются чертами характера или значениями слов.
Для обновления местоимения умножим каждую пару на её коэффициент из последней строки. Получится: 0,2 × [1; 0] + 0,7 × [0; 1] + 0,1 × [0,5; 0,5].
Считаем первую координату: 0,2 × 1 + 0,7 × 0 + 0,1 × 0,5 = 0,25. Вторую считаем отдельно: 0,2 × 0 + 0,7 × 1 + 0,1 × 0,5 = 0,75. Новое представление в нашем примере — [0,25; 0,75].
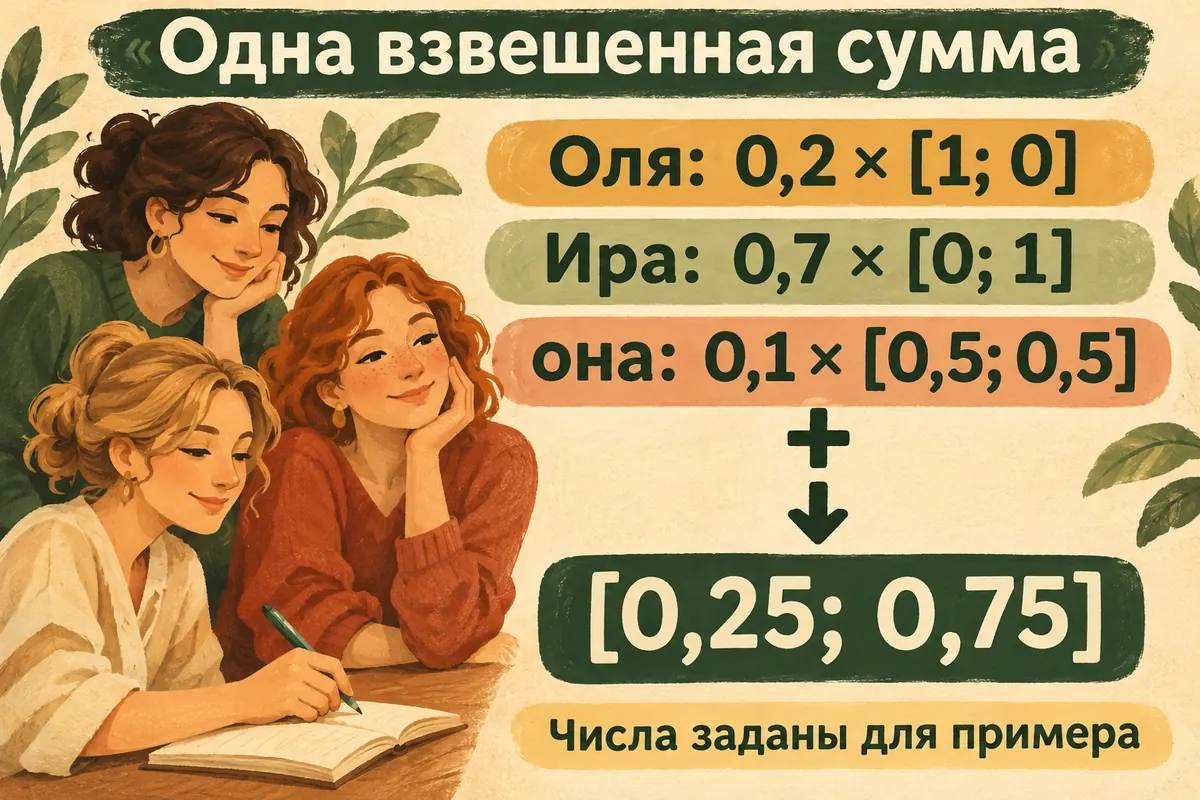
Каждая координата складывается отдельно. Результат — новый вектор для строки «она» в нашей маленькой схеме.
В этой паре заметнее вклад Иры, потому что мы заранее назначили ей наибольший коэффициент. Из пары не получается готовая русская подпись «выиграла Ира». Дальнейшие слои трансформера продолжают преобразовывать представления; наша операция закончилась раньше.
Чтобы проверить, поняли ли вы сам ход, временно поменяйте веса Оли и Иры в последней строке местами: 0,7; 0,2; 0,1. Сумма по-прежнему единица. С теми же исходными парами результат станет [0,75; 0,25]. Мы изменили распределение вкладов и получили другую смесь. Слова фразы при этом остались теми же. Этот поворот хорошо проверяет понимание: новый результат появился потому, что вы поменяли коэффициенты своего примера. Нового известия о школьном конкурсе никто не присылал.
Ещё одна быстрая проверка — взять для последней строки веса 0; 1; 0. Тогда в итог полностью перейдёт вектор Иры [0; 1]. Так легче увидеть, за что отвечает умножение: оно задаёт размер каждого вклада.
Откуда берутся коэффициенты в настоящем механизме
В работающем трансформере человек не заполняет для каждого предложения такую таблицу вручную. Из представлений элементов с помощью обученных преобразований получают запросы, ключи и значения — query, key, value. Запросы сопоставляют с ключами, полученные оценки переводят в нормированные веса, а затем смешивают значения.
Запрос и ключ помогают определить коэффициент связи; значение — тот числовой материал, который войдёт в сумму. Нормирование softmax даёт неотрицательные веса, складывающиеся по строке в единицу. Наш расчёт начинается с уже готовых коэффициентов и показывает последний шаг — взвешенную сумму.
Именно этот ход описан в разделе Attention оригинальной работы Vaswani и соавторов. Для первой встречи с темой важнее увидеть смысл операции, чем запомнить обозначения всех матриц. Подробности запросов, ключей, значений и блоков есть также в учебнике Яндекса.
У трансформера несколько голов внимания: параллельные преобразования могут учитывать разные связи, после чего результаты объединяются. И блоков тоже несколько. Внимание входит в архитектуру вместе с другими преобразованиями; одной таблицей устройство всей сети не исчерпывается.
К тому же важен порядок. «Оля поздравила Иру» и «Ира поздравила Олю» используют одинаковые имена, но роли у них меняются. Поэтому в вычислениях учитывают положение элементов. Короткое объяснение механизма становится понятнее, если держать перед глазами именно такую перестановку знакомых слов.
Помощник разберёт вашу фразу по одному вопросу
Откройте обычный чат DeepSeek и вставьте короткое предложение, в котором вам самим интересна связь слов. Можно начать с нашего:
Объясни мне внимание в трансформере на фразе «Оля рассказала Ире, что она выиграла». Сначала покажи два возможных прочтения. Затем задай один вопрос, чтобы проверить, понял ли я связь местоимения с именами. После моего ответа предложи маленький расчёт с тремя элементами: все придуманные веса назови иллюстративными, проверь сумму строки и одну взвешенную сумму. Не выдавай эти числа за внутренние данные твоей модели. Двигайся по одному шагу и жди моего ответа.
Прочитайте сначала только разбор двух вариантов. Можно заменить местоимение именем: «Оля рассказала Ире, что Оля выиграла» и «Оля рассказала Ире, что Ира выиграла». Повтор имени утяжеляет фразу, зато сразу видно, какие два смысла мы обсуждаем. Если вы собираетесь напечатать победительнице открытку, этой разницы уже достаточно, чтобы сначала уточнить имя. После этого спросите себя, какая недостающая деталь позволила бы выбрать один.
Если помощник сразу принёс большую таблицу и целую лекцию, верните его к одному шагу: «Пока проверь только, почему оба прочтения возможны». Для следующего действия уже есть опора — ваши собственные варианты фразы.
Затем можно дать ему готовую последнюю строку из нашей схемы и попросить разложить вычисление по координатам. Получив пару чисел, пересчитайте хотя бы одну координату сами. Здесь ИИ помогает пройти объяснение и обсудить результат; внутренние коэффициенты закрытого чата из такой беседы не извлекаются.
Что изменится, если дописать семейное сообщение
Добавим: «Приз стоял у Оли на полке». Читателю стало проще связать победу с Олей. Или допишем: «Ира побежала показывать медаль маме». Теперь естественнее другое прочтение. Для читателя новая деталь меняет основания выбора. Теперь можно объяснить, почему он склоняется к одному имени: появилась полка с призом или медаль у Иры. Числа в нашей заданной матрице от дописанного предложения сами не пересчитываются.
Есть важная особенность направления. В двунаправленной обработке представление местоимения может учитывать слова по обе стороны. В авторегрессивной генерации используется ограничение: позиция обращается к доступному предыдущему контексту и себе, не заглядывая в будущие токены. Когда чат позже формирует ответ, ему уже доступна присланная вами фраза целиком. Это разные моменты обработки.
Поэтому маленькую таблицу из трёх слов удобно рассматривать как отдельную схему смешивания, а не как схему всех позиций любого чата. Полный путь в трансформере включает разбиение текста, маски доступных связей, несколько голов, слоёв и последующие вычисления.
Из этого вырастает простой приём для собственных сообщений: когда местоимение допускает несколько участников, добавьте имя или одну поясняющую реплику. Можно попросить помощника найти двусмысленность в коротком тексте и предложить две ясные версии. Если хочется перейти от устройства сети к своей бытовой задаче, начните с первого небольшого дела с ИИ.
В «Первопроходцах» такой интерес можно продолжать на собственных материалах: разбирать непонятное, задавать вопросы, пробовать и улучшать проект с обратной связью. Для начала уже достаточно одного предложения, в котором вам захотелось разобраться.
Частые вопросы
Токен — это всегда слово?
Нет, он может быть частью слова или знаком. В нашей схеме целые слова взяты как удобное упрощение, без запуска конкретного токенизатора.
Почему сумма строки равна единице?
В показанном нормированном внимании это распределение долей вкладов. В нашей матрице суммы проверяются обычным сложением; в механизме исходной работы веса получают через softmax.
Вес 0,7 означает, что Ира выиграла с вероятностью 70 процентов?
Нет. Это выбранный коэффициент участия её вектора во взвешенной сумме. Вероятности ответа мы здесь не считали.
Можно попросить чат показать его настоящую матрицу внимания?
Обычная просьба объяснить предложение не даёт такого доступа. Полученные в ответ числа нужно рассматривать по заявленному происхождению: в нашем запросе они прямо заданы как иллюстрация.
Почему нельзя объяснить весь ответ одной яркой стрелкой?
Ответ трансформера зависит от дальнейших вычислений, множества голов и слоёв. Одна связь в выбранном месте показывает отдельный вклад, а не весь путь получения текста.
Что можно сделать без формул?
Взять короткую фразу, найти два возможных прочтения и добавить деталь, которая проясняет одно из них. Затем попросить DeepSeek проверить, стало ли понятнее, кто что сделал.
Оля и Ира пока могут обе претендовать на победу. Вы уже умеете отделить связь слов от заданного числового примера и сами получить новую пару чисел. А для надписи на торте остаётся задать один короткий вопрос: «Кто всё-таки выиграл?» С этим уточнением нейросети тоже будет легче помочь.